당신이 개인 블로그를 직접 운영해야 하는 이유
블로그를 운영한 지 1년 8개월이 되었습니다.
직접 만든 블로그는 글만 쓰면 끝나는 공간이 아닙니다. 콘텐츠의 구조를 정하고, 검색엔진에 주소를 알리고, 디자인을 유지하고, 빌드와 배포를 관리하고, 성능과 숫자를 다시 확인해야 합니다. 도메인을 사고 정적 사이트를 올리는 데까지는 연휴 하루면 끝났는데, 그 뒤로 생긴 문제는 대체로 글과 상관이 없었습니다. 커밋 훅의 검사기는 초록불인데 정작 검사를 하지 않고 있었고, 댓글은 저장됐는데 다음에 그 페이지를 여는 사람에게는 보이지 않았습니다.
귀찮은 일처럼 보이지만 저는 오히려 이것이 개인 블로그를 직접 운영할 이유라고 생각합니다. 회사에서는 이미 결정된 채 만나는 것들을 작은 규모에서 처음부터 끝까지 직접 결정해 볼 수 있기 때문입니다.
직접 블로그를 운영하면 어떤 기술을 쓰는지보다, 웹 서비스를 만드는 동안 무엇을 결정해야 하는지를 배우게 됩니다.
서비스 생애주기에 따른 열 개의 기술 영역
개인 블로그 하나를 직접 운영하는 일은 작은 풀스택 웹 서비스를 운영하는 일에 가깝습니다. 만들어 올리고 나면 보통 아래 열 개의 기술 영역을 차례로 다루게 됩니다.
- 콘텐츠 엔지니어링: 글을 스키마와 검증을 가진 데이터로 다룹니다
- 정보 구조와 검색 노출: 주소와 어휘와 색인 정책을 정돈합니다
- 디자인과 브랜딩: 색과 글꼴과 썸네일과 말투를 한 인상으로 묶습니다
- 프론트엔드와 표현 계층: 화면에서 실행되는 모든 것을 만듭니다
- 빌드 엔지니어링과 자동화: 기억해야 하는 규칙을 빌드가 검사하게 옮깁니다
- 호스팅, 인프라와 배포: 도메인과 DNS와 인증서와 캐시 헤더를 다룹니다
- 백엔드와 서버리스: 빌드 시점에 답이 정해지지 않는 기능을 붙입니다
- 보안과 접근 제어: 인증과 권한과 비밀값, 그리고 외부 입력을 다룹니다
- 웹 성능: 측정하고 병목을 찾고 다시 측정합니다
- 측정과 데이터 분석: 다음에 무엇을 할지 정합니다
회사에서 일하면 이 영역들은 대개 나뉘어 있습니다. 배포는 플랫폼 쪽이, 검색은 마케팅이, 측정은 데이터 쪽이 맡고, 각자 자기 영역에서 이미 정해진 규칙을 따릅니다. 규칙이 왜 그 모양인지는 잘 보이지 않습니다. 결정은 대체로 내가 오기 전에 내려져 있습니다.
작은 서비스 하나를 처음부터 끝까지 혼자 굴리면 그 경계가 없어집니다. 규모가 작으니 틀렸을 때 부담도 없고, 결정과 책임은 온전히 만든 사람의 몫입니다. 직접 한 번 정해 보면 회사에서 남이 정해 놓은 규칙을 만났을 때 그 규칙이 무엇을 의미하는지 알 수 있습니다.
각 영역에서 무엇을 고를 수 있으며 그 선택이 무엇을 바꾸는지를 이 블로그의 사례로 정리합니다. 제가 고른 쪽이 정답이라는 뜻은 아닙니다. 어떤 것은 다르게 골라도 되고, 어떤 것은 고르지 않아도 됩니다. 다만 선택지가 있다는 것을 모르면 기본값을 고른 줄도 모르게 되므로, 기본값이 무엇이고 그것을 두면 어떻게 되는지를 함께 적었습니다.
도구 사용법이나 구축 절차는 다루지 않습니다.
검색 노출은 이 블로그를 운영하며 배운 SEO에서 설정과 출력 결과까지 따로 정리했으므로 여기서는 개요만 둡니다.
무엇을 만들고 어떻게 보여줄 것인가
1. 콘텐츠 엔지니어링
한 편의 글을 쓰는 것과 일정한 품질의 글을 계속 쌓아 가는 것은 조금 다른 문제입니다. 글이 많아질수록 블로그 콘텐츠도 구조를 가진 데이터로 다룰 필요가 생깁니다.
구조: 글은 어떤 데이터로 이루어지는가
성격이 다른 값들이 한 파일에 모여 있습니다.
| 묶음 | 들어가는 값 |
|---|---|
| 메타정보 | 제목, 요약, 작성일과 수정일, 카테고리와 태그, 대표 이미지, 작성자, 검색 결과용 제목과 요약 |
| 본문 구조 | 제목 단계, 문단 흐름, 목차, 내부 링크, 외부 출처, 인용 |
| 표현 요소 | 이미지, 도식, 표, 코드 블록, 콜아웃, 캡션과 대체 텍스트, 다크 모드와 좁은 화면에서의 표시 |
규약: 각 데이터가 어떤 형태를 가져야 하는가
어떤 값은 반드시 있어야 하는지, 요약은 얼마나 길어야 하는지, 태그는 자유롭게 추가할 수 있는지 같은 것들입니다. 문체와 표기법, 제목 짓는 방식처럼 모든 글에 같게 적용되는 것도 여기 들어갑니다. 이 블로그도 한때 태그가 364개까지 늘어났고, 전수 조사해 83개로 줄인 뒤 사용할 수 있는 어휘를 따로 관리하고 있습니다.
관계: 다른 글 및 사이트 전체와 어떻게 연결되는가
한 파일 안에서 끝나지 않는 값입니다. 카테고리 체계, 연재 순서, 관련 글, 오래된 글과 새 글의 연결이 여기 해당합니다. 연재 순서나 관련 글 목록을 각 글에 손으로 적어 두면 한 편이 늘 때마다 나머지를 전부 고쳐야 하고, 그 비용은 대개 누락으로 드러납니다.
검증: 그 규칙이 계속 지켜지고 있는지 어떻게 확인하는가
기계가 판단할 수 있는 것과 사람이 판단해야 하는 것을 갈라 두면 됩니다.
| 게이트 | 보는 것 |
|---|---|
| 기계 | 필수 메타정보 누락, 요약 길이 초과, 허용되지 않은 태그, 깨진 내부 링크, 없는 이미지, 어긋난 제목 단계, 깨진 마크다운 |
| 사람 | 사실이 맞는가, 주장에 근거가 있는가, 읽기에 자연스러운가, 장황하지 않은가, 글이 던진 질문에 답하는가, 기존 글과 말투가 어긋나지 않는가 |
앞쪽은 커밋 전에 자동으로 막고, 뒤쪽은 막을 수 없으므로 작성 기준을 문서로 두고 초고를 그 기준으로 훑습니다.
이 경계는 요즘 빠르게 움직이고 있습니다. 예전에는 검사 하나를 늘리려면 스크립트를 직접 짜야 해서 규칙이 있어도 문서에만 적어 두는 일이 많았는데, 지금은 이런 규칙을 검사로 옮기는 비용도 많이 낮아졌습니다. 문체나 표기의 일관성, 장황한 문단처럼 사람 몫으로 두던 것도 초벌은 기계가 봐 줍니다. 그래서 기억에 맡기던 규칙을 검사로 옮기는 일이 예전보다 훨씬 싸졌습니다. 다만 사실관계와 글의 목적은 여전히 사람이 봐야 합니다. 기계는 규칙을 어겼는지 판정할 뿐, 그 글이 맞는 말을 하는지와 애초에 쓸 만한 글인지는 판정하지 않습니다.
글 한두 편에서는 이런 구조가 없어도 별문제가 없습니다. 하지만 수십 편이 쌓이면 규칙이 없는 부분부터 조금씩 달라집니다. 콘텐츠를 데이터로 다루는 이유는 글을 기계적으로 만들기 위해서가 아니라, 글이 늘어나도 품질의 기준이 함께 유지되게 하기 위해서입니다.
2. 정보 구조와 검색 노출
여기서는 무엇을 정해야 하는지까지만 다룹니다. 구체적인 설정과 실제 출력 결과는 이 블로그를 운영하며 배운 SEO에 정리했습니다.
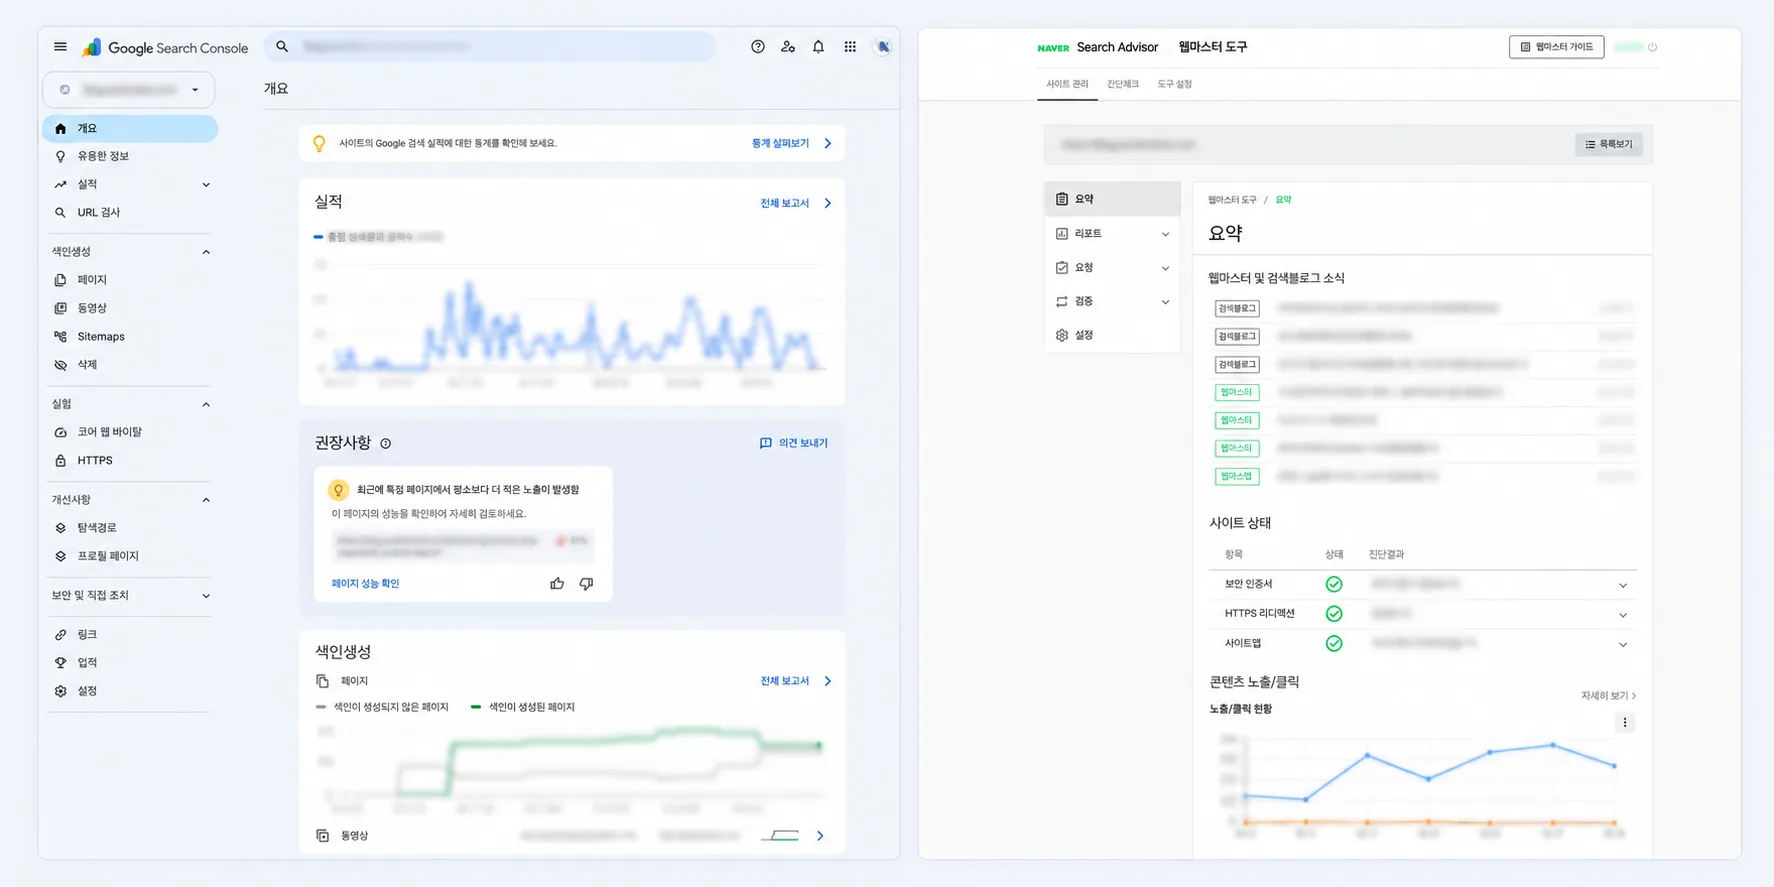
사이트를 올린다고 검색 결과에 나타나는 것은 아닙니다. 검색 노출은 글의 내용만큼이나 주소와 사이트 구조의 영향을 받습니다. 색인된 페이지 수와 사이트맵 제출 상태, HTTPS 리디렉션 설정은 구글 서치 콘솔과 네이버 서치어드바이저에서 확인합니다.
주소: 한 글의 대표 주소는 무엇인가
주소 끝의 슬래시(trailing slash)가 있고 없고, 대소문자나 쿼리 파라미터가 다른 주소까지 같은 글로 열릴 수 있습니다.
https://blog.wonkooklee.com/blog/20250126_01/                      # 내가 대표로 쓰는 주소
https://blog.wonkooklee.com/blog/20250126_01                       # 끝의 슬래시가 없다
http://blog.wonkooklee.com/blog/20250126_01/                       # http 로 들어왔다
https://blog.wonkooklee.com/blog/20250126_01/?utm_source=linkedin  # 캠페인 파라미터가 붙었다
사람이 보기에는 넷 다 같은 글이지만 검색엔진에는 각각 다른 주소입니다. 이런 주소가 여러 개라면 어느 주소를 대표로 사용할지 정하고 일관되게 알려 줄 필요가 있습니다. 이렇게 정한 대표 주소를 정규 주소, 영어로는 canonical URL이라고 합니다. 각 페이지가 <link rel="canonical"> 로 자기 대표 주소를 가리키게 해서 알립니다.
검색엔진도 여러 신호를 바탕으로 대표 주소를 정합니다. 이 선언과 리디렉션, 사이트맵이 모두 같은 주소를 가리키면 그 판단을 돕습니다. 선언 자체는 강제가 아니라 힌트이므로, 신호가 서로 다른 주소를 가리키면 내가 의도한 것과 다른 주소가 대표로 선택될 수 있습니다.
색인: 어떤 페이지를 검색 결과에 남길 것인가
모든 페이지가 검색 결과에 들어갈 필요는 없습니다. 읽을 콘텐츠와 탐색을 위해 존재하는 페이지를 나누고, 무엇을 색인할 것인지 정해야 합니다.
여기서 크롤링을 막는 것과 색인에서 제외하는 것은 다른 일입니다. 크롤러의 접근 자체를 막으면 페이지에 적힌 noindex를 읽을 수 없으므로, 검색에서 빼려는 목적과 충돌할 수 있습니다.
선언: 이 페이지가 무엇인지 어떻게 설명할 것인가
사이트맵은 어떤 주소가 있는지를 알려 주고, 구조화 데이터는 이 페이지가 어떤 종류의 콘텐츠인지, 제목과 작성자 같은 정보는 무엇인지 기계가 읽을 수 있는 형태로 설명합니다.
중요한 것은 여러 선언이 실제 사이트와 같은 내용을 가리키는 것입니다. 이 블로그에서도 사이트맵에 적힌 주소와 호스팅이 실제로 내보내는 주소가 달라 Search Console에 리디렉션 URL이 쌓인 적이 있습니다.
어휘: 사람이 검색하는 말과 어떻게 만날 것인가
화면에 다는 제목과 사람들이 검색창에 입력하는 말은 자주 다릅니다. 이 블로그의 제목은 질문형이 많은데, 실제 검색어는 기술명이나 문제 상황을 직접 적는 경우가 많았습니다. 그래서 화면에서 읽히는 제목과 검색 결과에 사용할 제목을 필요에 따라 분리하고 있습니다.
유통 경로: 글은 검색 말고 어디로 나가는가
검색엔진만 글을 소비하는 것은 아닙니다. RSS 같은 피드를 제공하면 독자에게는 피드 리더가 또 하나의 입구가 됩니다.
사이트가 새 글 목록을 정해진 형식의 XML로 내보내는 것입니다. 독자가 그 주소를 피드 리더에 등록해 두면 여러 사이트의 새 글을 한곳에서 받아 볼 수 있습니다. Atom은 같은 목적의 다른 피드 형식이며, 사이트에 따라 하나 또는 둘 다 제공합니다.
이때 각 항목의 식별자는 주소와 별개의 의미를 가질 수 있습니다. 피드 리더는 이 값을 이용해 이미 본 글인지 새 글인지 판단할 수 있으므로, 기존 글의 주소를 바꾸더라도 식별자가 불필요하게 함께 바뀌지 않도록 관리해야 합니다.
SEO는 검색창에 키워드를 몇 개 넣는 작업이라기보다, 사람과 기계가 콘텐츠의 주소와 구조를 일관되게 이해할 수 있도록 만드는 일에 가깝습니다.
3. 디자인과 브랜딩
디자인 시스템까지 가지 않아도 정해야 할 것이 남습니다. 로고와 파비콘, 글꼴, 색과 다크 모드, 대표 이미지, 공유 카드, 그리고 그것들을 관통하는 말투입니다.
이 영역의 일은 화면 하나를 예쁘게 만드는 것이 아니라, 흩어져 도착한 글이 같은 곳에서 왔다고 읽히게 하는 것입니다. 독자는 대체로 목록이 아니라 검색 결과나 타임라인에서 글 한 편씩 만나기 때문입니다.
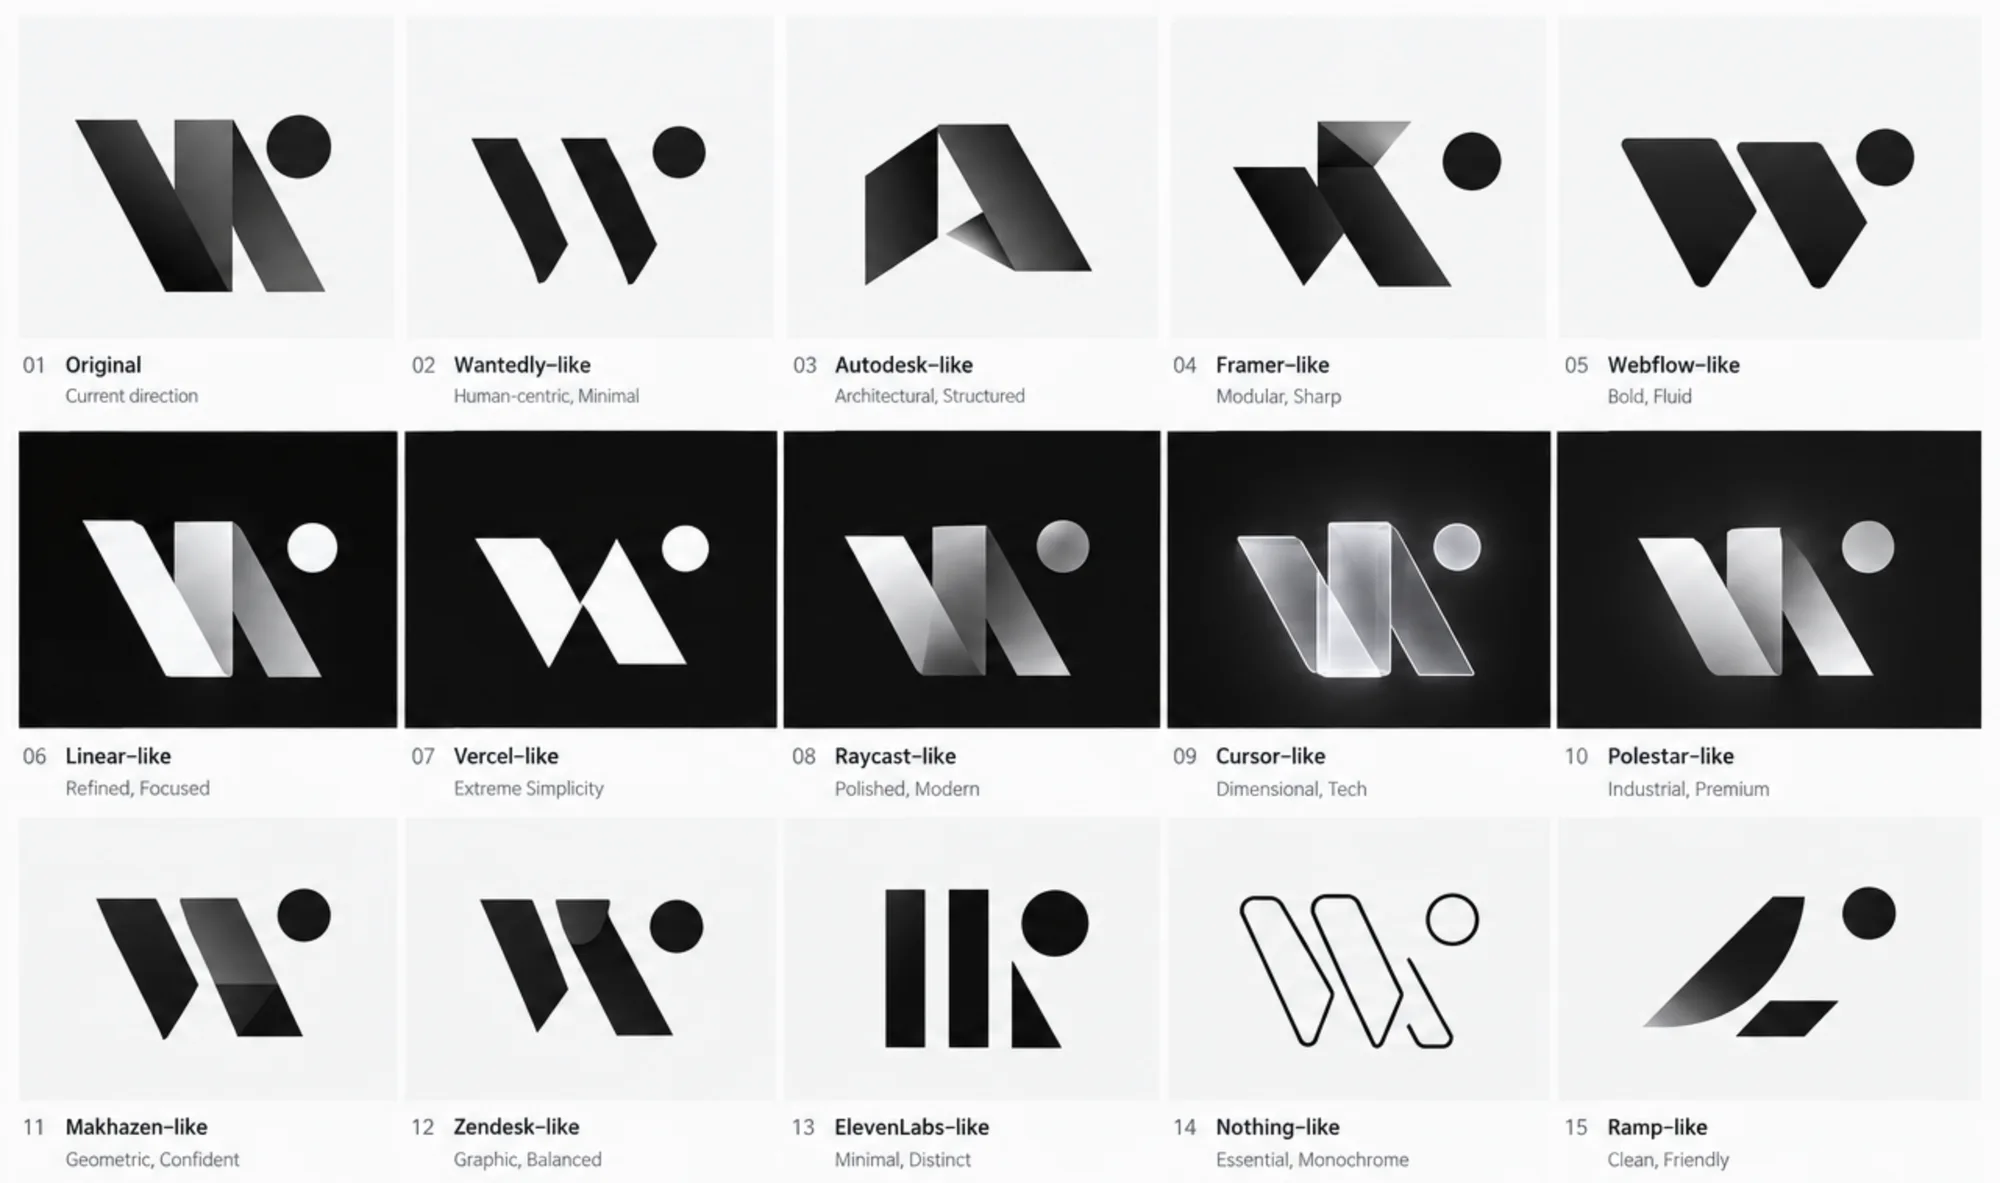
로고처럼 한 번 정하면 오래 쓰는 것은 방향을 여러 개 만들어 놓고 고르는 편이 낫습니다. 같은 글자를 두고 나란히 놓으면 말로 설명하기 어려웠던 인상의 차이가 눈에 들어옵니다. 여기서 고른 인상이 파비콘과 공유 카드, 대표 이미지까지 따라갑니다.
그래서 반복해서 쓰이는 색과 글꼴 같은 값은 어디에서 관리할지, 글마다 만들어지는 대표 이미지와 공유 카드에는 어떤 규칙을 둘지 정하게 됩니다. 같은 색을 화면마다 따로 적어 두면 어느 날 한 화면만 달라지고, 대표 이미지를 매번 새로 상상하면 글마다 결과가 달라집니다. 배경색과 팔레트, 각 색의 역할, 이미지가 따를 구도를 미리 정해 두면 선택해야 할 것이 줄어듭니다. 주제가 제각각이어도 같은 규칙으로 만들면 한 사람의 글로 보입니다.
말투도 같은 역할을 합니다. 제목을 짓는 방식이나 기술 용어를 적는 방법처럼 반복되는 표현에 기준을 두면, 서로 다른 시기에 쓴 글도 같은 목소리를 유지하기 쉬워집니다.
브랜딩이 기술 결정으로 내려오는 자리도 있습니다. 공유 카드는 충분한 크기의 이미지를 요구하고, 실제 화면은 가벼운 파일을 원합니다. 하나의 파일로 둘 다 해결하려 하면 어느 한쪽에서 비용을 치르게 됩니다. 어떤 인상을 유지할 것인지 정한 뒤 그 규칙을 디자인과 구현 양쪽에 어떻게 남길 것인지가 이 영역의 일입니다.
4. 프론트엔드와 표현 계층
화면에서 실행되는 모든 것이 이 영역입니다. 레이아웃과 탐색, 목록과 카드, 댓글이나 검색 같은 위젯, 그리고 읽는 환경을 조절하는 기능이 들어갑니다.
정적 사이트에는 제약이 하나 붙습니다. 서버가 미리 그려 둔 HTML과 브라우저가 처음 그리는 화면이 같아야 합니다. 방문할 때마다 달라져야 좋은 기능이 대체로 이 제약과 부딪힙니다. 무작위로 고르는 추천 목록이나 매번 다른 글에서 시작하는 캐러셀이 그렇습니다.
결과가 빌드 시점에 정해지도록 규칙을 바꾸거나, 기능을 포기하거나, 값을 치르고 유지하면 됩니다. 이 블로그의 관련 글 목록은 규칙을 바꾼 쪽입니다. 무작위 대신 두 글의 주소를 이어 붙여 해시한 값으로 정렬해서, 글마다 다른 조합이 나오면서도 같은 글은 배포가 바뀌어도 같은 목록을 유지합니다. 홈 캐러셀은 값을 치른 쪽입니다. 첫 화면 렌더링을 한 번 되돌리는 대가를 치르는데, 통제해서 비교해 보니 LCP는 약 1초 늘었고 Lighthouse 성능 점수는 6점 낮아졌습니다. 측정하고 받아들인 손해와 모르고 내는 손해는 다릅니다.
나머지는 읽는 조건이 사람마다 다르다는 데서 옵니다. 글자를 키워 읽는 사람이 있고, 움직임을 줄여 둔 사람이 있고, 화면을 소리로 듣는 사람이 있습니다. 여기서 확인할 것은 본문만이 아니라 표현 요소까지 함께 움직이는가입니다. 글자만 키우면 좌표가 고정된 도식에서 이름표가 상자를 뚫고 나가고, 좌표계째 늘리면 이번에는 이미지까지 따라 커집니다. 어느 쪽이든 본문에 무엇이 들어 있는지를 알아야 고를 수 있습니다.
목록 카드에서도 같은 판단이 나옵니다. 발췌를 본문 앞부분에서 자동으로 가져오면 사진으로 시작하는 글과 표로 시작하는 글의 카드 높이가 크게 벌어집니다. 요약 필드를 대신 쓰면 고르게 떨어지는데, 메타정보에 길이 상한을 둔 결정이 여기서 값을 하는 셈입니다.
Recap
이 단원에서 정하는 값은 대부분 나중에 바꾸기 어렵습니다. 주소 형태와 분류 어휘는 바꾸는 순간 기존 링크와 색인이 흔들리고, 색과 글꼴은 화면마다 따로 적어 두면 어느 날 한 화면만 달라집니다.
표현 계층에서는 서버가 그린 화면과 첫 클라이언트 렌더가 같아야 한다는 제약을 먼저 확인해야 합니다. 이 제약을 깨는 기능은 대개 독자에게 좋은 기능이라 포기하기 어렵습니다. 그때는 비용을 재서 받아들일지 정하고 그 결정을 기록으로 남기는 편이 낫습니다.
어떻게 만들어서 안정적으로 전달할 것인가
5. 빌드 엔지니어링과 자동화
사람이 기억해야 하는 규칙을 하나씩 빌드 규칙으로 옮깁니다.
빌드는 원문을 화면이 쓸 형태로 바꾸고, 규칙에 맞는지 검사하고, 배포할 수 있는 묶음으로 만듭니다.
검증: 무엇을 검사할 것인가
기억해야만 지켜지는 규칙은 언젠가 깨집니다. 반복해서 지켜야 하고 판정 기준이 분명한 것부터 검사로 옮기면 됩니다. 콘텐츠 규약만이 아니라 링크가 실제로 열리는지, 참조하는 파일이 있는지, 설정끼리 모순되지 않는지도 대상입니다.
실패 기준: 어디서 작업을 멈출 것인가
무엇을 경고로 두고 무엇을 빌드 실패로 둘 것인가를 정해야 합니다. 경고는 쌓이기 시작하면 쉽게 무시되기 때문에, 조용히 늘어나는 종류는 실패로 두는 편이 낫습니다. 많은 도구가 이런 항목의 기본값을 경고로 둡니다. 멈추지 않는 쪽이 처음 쓰는 사람에게 친절하기 때문인데, 오래 굴릴 사이트에서는 반대가 됩니다.
애초에 멈추지 않는 종류도 있습니다. 여러 변환을 거친다면 순서도 규칙의 일부가 됩니다. 뒤의 단계는 앞의 단계가 바꿔 놓은 결과를 입력으로 받기 때문입니다. 순서를 잘못 두면 빌드가 실패하는 대신 결과물만 조용히 달라집니다.
실행 위치: 커밋, 빌드, 주기 점검 중 어디에서 검사할 것인가
커밋 전에 도는 검사는 빠르고 결과가 결정적이어야 합니다. 네트워크를 타거나 외부 토큰이 필요한 검사를 여기 넣으면 연결이 없는 곳에서 커밋이 막힙니다. 그런 검사는 주기적으로 도는 쪽으로 빼면 됩니다.
검사기의 검증: 자동화가 실제로 실패할 수 있는가
가장 비싼 실패는 검사기가 돌지 않는 것입니다. 검사를 붙이는 것과 검사가 실제로 도는 것은 다른 일입니다. 필요한 의존성이 없으면 경고만 찍고 정상 종료하는 검사기, 명령을 파이프로 이어서 앞 명령의 실패가 뒤 명령의 성공에 덮이는 CI 단계가 그렇습니다. 둘 다 초록불이 켜지고, 초록불은 확인했다는 뜻으로 읽힙니다. 이 블로그에서도 글꼴 검사기와 댓글 점검 워크플로가 각각 그 상태로 한동안 돌고 있었습니다. 그래서 검사기를 붙인 다음에는 일부러 틀린 입력을 한 번 넣어 빨간불을 확인하는 편이 낫습니다.
6. 호스팅, 인프라와 배포
도메인: 서비스의 주소를 누가 소유하고 어디를 가리키게 할 것인가
도메인을 사면 결정이 따라옵니다. 네임서버를 어디에 둘지, 루트를 쓸지 서브도메인을 쓸지, www가 붙은 주소와 붙지 않은 주소 중 무엇을 정식으로 삼을지입니다. 그다음 레코드를 만지고 인증서를 받으면서 DNS를 한 번 더 건드리게 됩니다. 이 블로그는 도메인을 AWS Route 53에서 관리합니다.
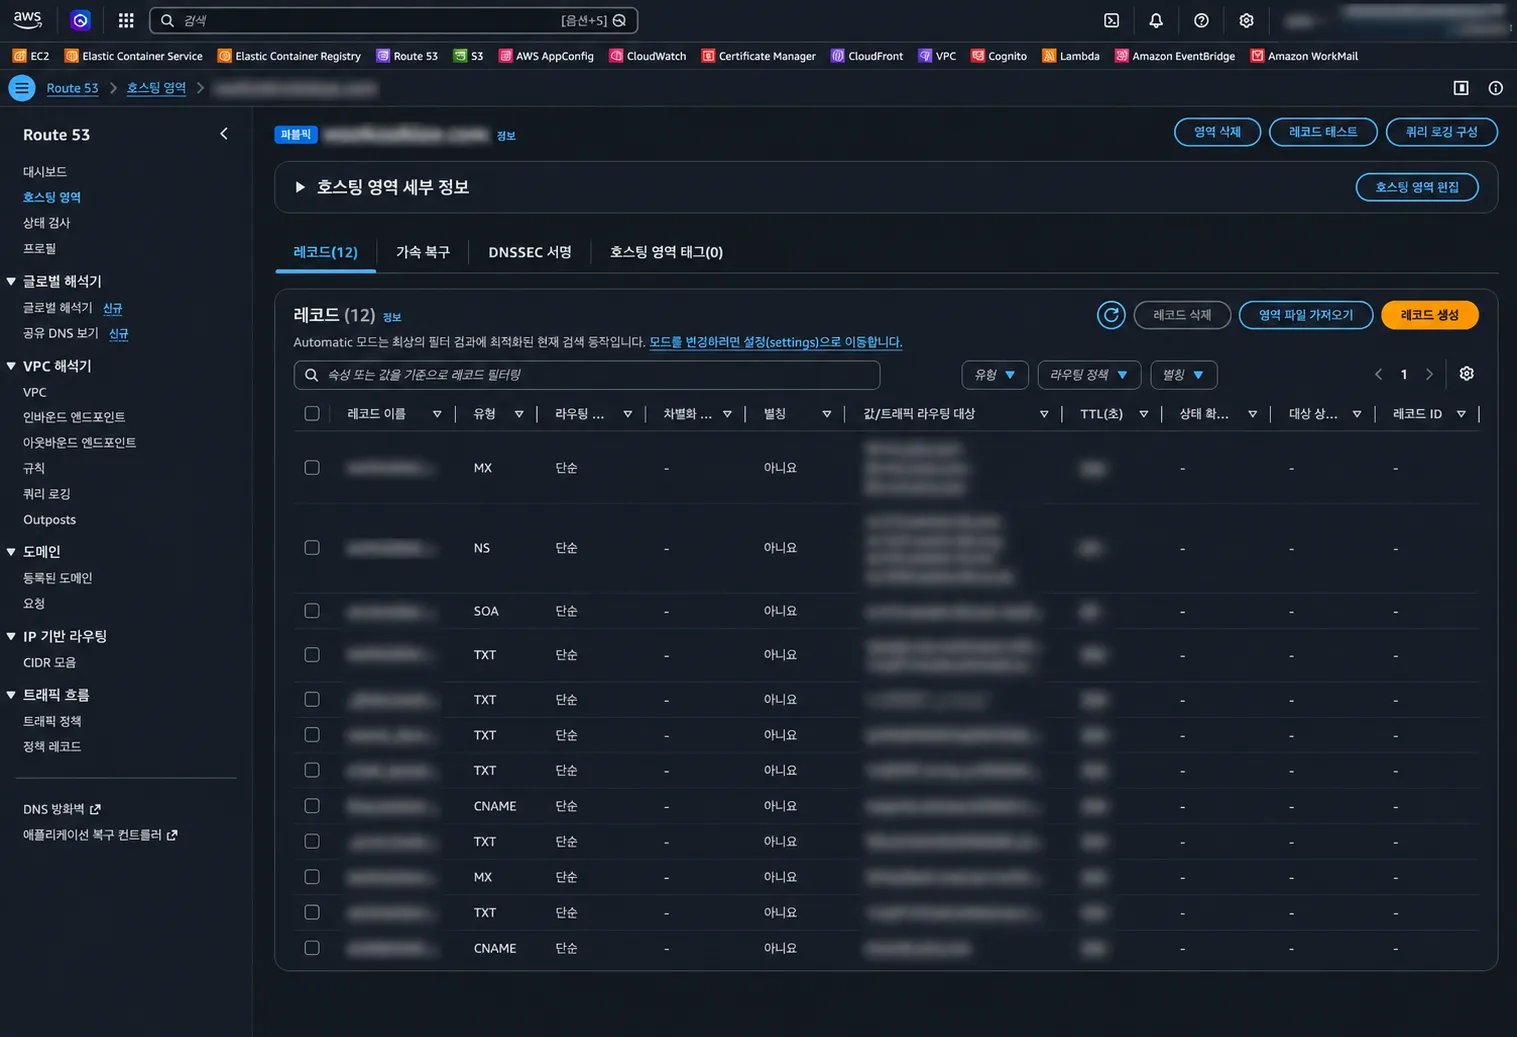
열두 줄 중 블로그가 쓰는 것은 둘입니다. blog 하위 도메인을 호스팅으로 넘기는 CNAME과, 인증서를 발급받을 때 소유를 확인하는 TXT입니다. 나머지는 같은 도메인에 얹은 다른 일이 차지합니다. 메일을 받는 MX, 보낸 메일이 위조가 아님을 증명하는 SPF와 DKIM, 외부 서비스에 도메인이 내 것임을 확인시키는 TXT가 그렇습니다. 도메인을 하나 가지면 서로 다른 서비스의 기록이 이렇게 한 영역에 모입니다. 줄마다 왜 있는지 적어 두지 않으면 나중에 무엇을 지워도 되는지 판단할 수 없게 됩니다.
여기서 남는 것은 DNS 지식보다 콘텐츠의 주소를 내가 갖는다는 감각입니다. 플랫폼이 제공한 주소에 의존하면 다른 곳으로 옮길 때 기존 주소를 그대로 유지하기 어렵습니다. 직접 가진 도메인은 호스팅을 옮기든 기술을 바꾸든 같은 주소를 계속 쓰므로, 지금 쓰는 기술이나 서비스 이름을 주소에 넣지 않는 편이 낫습니다.
배포: 변경을 어떤 경로로 운영까지 보내고 어떻게 되돌릴 것인가
배포는 대개 저장소 푸시에 걸어 둡니다. 그러면 배포가 따로 하는 작업이 아니라 커밋의 결과가 됩니다. 이 블로그는 Netlify에 올려 두고 release 브랜치에 푸시하면 배포가 시작되게 해 두었습니다.
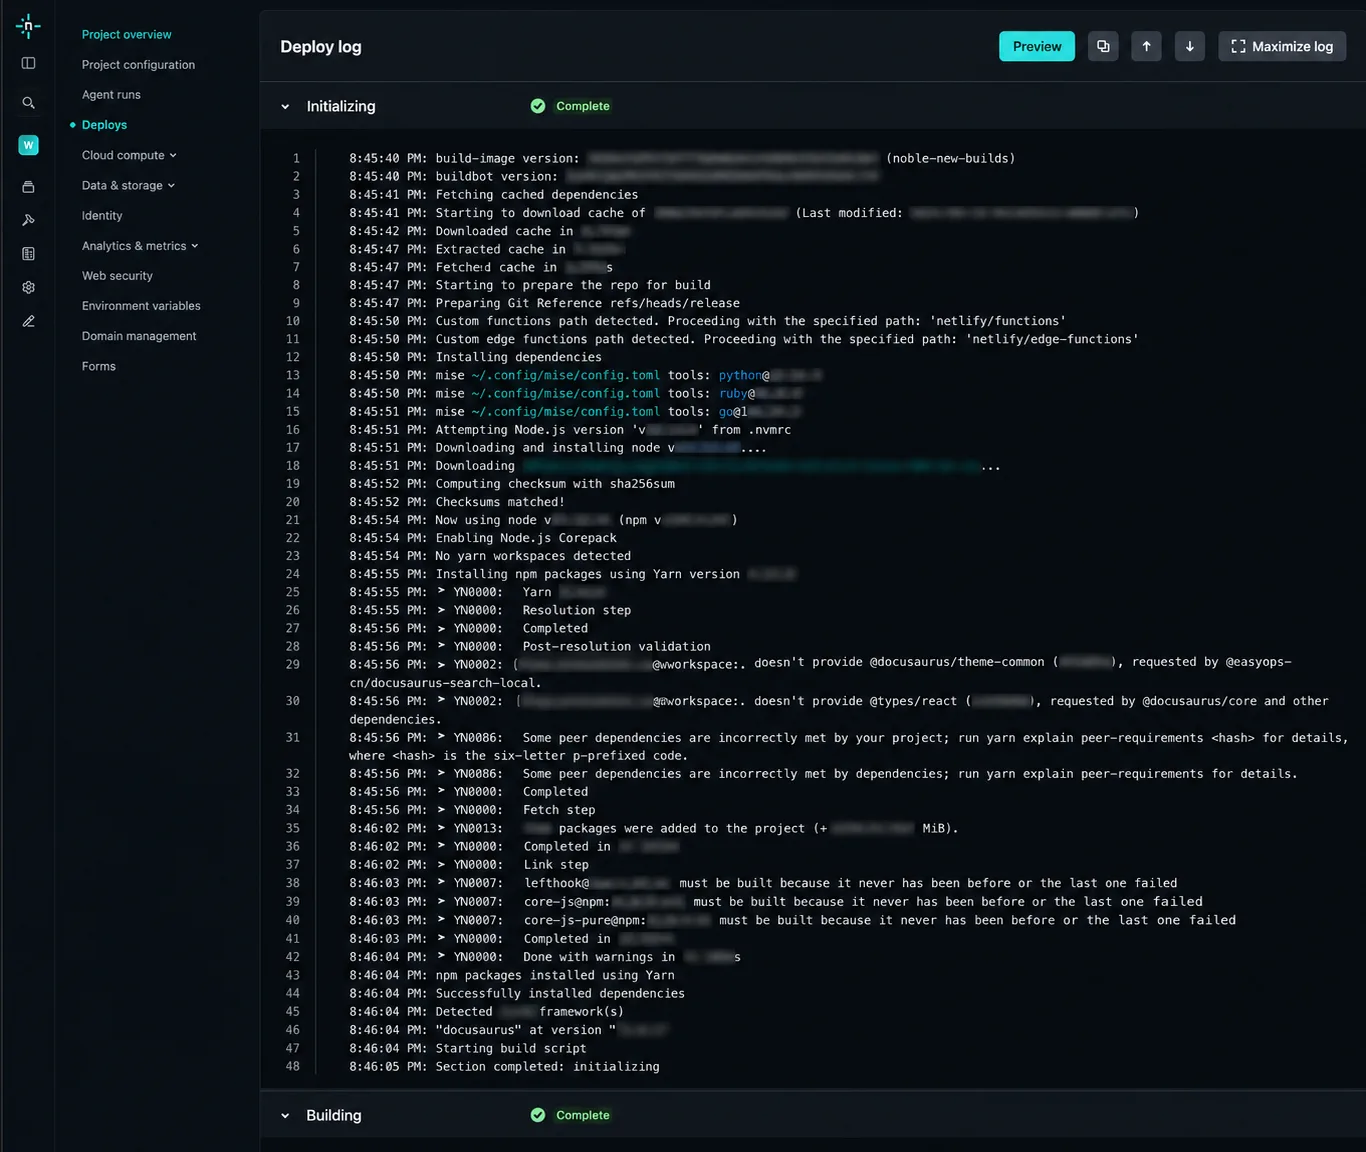
자동으로 나가게 만들었다면 실패했을 때 어디까지 자동으로 멈출지, 이미 나간 버전은 어떻게 되돌릴지도 함께 정해야 합니다. 되돌리는 방법을 정해 두지 않으면 자동화는 잘못된 결과도 같은 속도로 내보냅니다.
캐시: 어떤 결과를 얼마 동안 재사용할 것인가
캐시를 오래 유지할수록 다시 내려받는 비용은 줄지만, 바뀐 파일을 언제 새것으로 바꿀지가 문제가 됩니다. 그래서 내용이 바뀌면 파일 이름도 달라지는 자산과, 주소가 그대로 유지되는 파일에는 서로 다른 정책이 필요합니다. 모든 파일에 같은 캐시 규칙을 적용할 수 없는 이유입니다. 호스팅의 기본값은 대개 안전한 쪽, 즉 매번 다시 확인하는 쪽이라 재방문하는 독자가 그 값을 치릅니다.
7. 백엔드와 서버리스
정적 사이트와 동적 서비스는 양자택일이 아닙니다. 빌드 시점에 답이 정해지지 않는 기능만 함수로 떼어내면 됩니다.
언제 서버가 필요한가
시간이 지나면 값이 바뀌는 것, 요청한 사람에 따라 답이 달라지는 것, 비밀값이 필요해서 브라우저에서는 할 수 없는 것이 그렇습니다.
값이 바뀌는 기능에서 정할 것은 언제 가져오느냐입니다. 빌드 시점의 스냅샷만 두면 다시 배포하기 전까지 새 값이 보이지 않고, 화면이 뜬 뒤에 가져오면 최신이지만 그 요청은 실패할 수 있습니다. 대개 둘 다 둡니다. 커밋된 스냅샷을 먼저 보여 주고 함수가 가져온 값으로 갱신하면, 토큰이 없는 환경에서도 빌드가 돌고 화면도 비지 않습니다.
무엇을 정적 산출물에 넣으면 안 되는가
로그인 뒤에서만 보여야 하는 내용을 정적 빌드에 넣고 화면에서만 가리면, 그 내용은 이미 공개된 파일 안에 있습니다. 함수가 인증을 통과한 요청에만 만들어 보내면 산출물에도 공개 번들에도 들어가지 않습니다. 무엇을 산출물에서 빼느냐가 실제 방어선입니다.
외부 서비스에 기댄 기능은 어떻게 실패를 알아차릴 것인가
외부 서비스에 기대는 기능에는 그 서비스의 실패 방식도 함께 따라옵니다. 이 블로그의 댓글은 GitHub Discussions를 사용하는데, 스레드가 검색되지 않으면 댓글 작성은 성공해도 다음 방문자에게는 보이지 않는 문제가 있었습니다. 내가 만든 코드가 정상이어도 외부 서비스의 상태 때문에 기능이 조용히 깨질 수 있으므로, 이런 기능은 별도의 점검이 필요합니다.
8. 보안과 접근 제어
공개 블로그에도 보호할 것이 생깁니다. 아무에게나 보여 주고 싶지 않은 페이지, 브라우저로 내려보내면 안 되는 키, 그리고 방문자가 준 값을 서버가 대신 처리하는 기능입니다.
접근 제어: 누가 무엇을 볼 수 있는가
누구인지 확인하는 일과 그 사람이 이 페이지를 볼 수 있는지 판단하는 일은 다릅니다. 둘을 하나로 합쳐 두면 한 페이지의 범위를 좁히려다 무관한 페이지까지 잠깁니다. 확인은 한 번 해 두고 조건은 페이지마다 따로 두면 됩니다. 인증에 쓰는 값은 위조되거나 다른 용도로 재사용되지 않도록 해야 합니다.
외부 입력: 정상 입력으로는 드러나지 않는다
외부 입력을 서버가 대신 처리하는 기능은 정상 입력만 시험해서는 안전성을 확인할 수 없습니다. 허용할 프로토콜과 목적지를 제한하고, 내부망으로 향하는 요청이나 리다이렉트 우회를 막아야 합니다. 보안은 하나의 검사로 끝나는 문제가 아니라 서로 다른 우회를 막는 여러 겹의 방어로 다뤄야 합니다. 그리고 이 영역은 직접 써 봐서는 발견되지 않습니다. 정상 입력으로는 전부 통과하기 때문입니다.
기록: 무엇을 남길 것인가
무엇을 남길지는 기능이 아니라 정책입니다. 방문 기록처럼 개인정보가 섞일 수 있는 값은 목적에 필요한 만큼만 남깁니다. 원문이 필요하지 않다면 저장하지 않고, 필요하다면 보존 기간과 가공 방법을 함께 정합니다. 외부에서 들어오는 값에는 저장할 길이에도 상한을 둡니다. 사고가 나야 보이는 것이 아니라 처음 설계할 때 정하면 되는 것들입니다.
Recap
이 단원의 공통점은 정상 동작만 확인해서는 충분하지 않다는 것입니다.
빌드는 실패해야 할 때 실제로 실패하는지 확인해야 하고, 배포는 되돌릴 수 있어야 하며, 외부 서비스는 조용히 깨질 수 있다는 전제로 점검해야 합니다. 보안도 정상 입력이 아니라 잘못된 입력과 우회를 기준으로 설계해야 합니다.
서버리스 역시 같은 기준으로 고를 수 있습니다. 서버가 있느냐 없느냐보다 빌드 시점에 답이 정해질 수 있는가를 먼저 봅니다. 그렇지 않은 기능만 동적으로 분리하면 정적 사이트의 장점을 유지하면서 필요한 기능을 붙일 수 있습니다.
운영하면서 어떻게 개선할 것인가
9. 웹 성능
성능 작업은 기법을 외워 두었다가 꺼내는 일이 아니었습니다. 측정 → 병목 확인 → 변경 → 다시 측정을 반복하는 일이었습니다.
처음 보는 것은 총점이 아니라 그 점수를 구성하는 항목입니다. 어떤 항목이 느린지에 따라 할 일이 달라집니다. 자바스크립트 실행 시간과 레이아웃 이동에는 문제가 없는데 첫 화면이 늦다면, 코드보다 전송되는 자원의 크기와 순서를 먼저 살펴볼 수 있습니다.
정적 블로그에서 무거운 것은 대개 글꼴과 첫 화면의 큰 이미지, 분석이나 위젯 같은 외부 스크립트입니다. 셋은 각각 다른 이유로 무겁습니다.
글꼴은 굵기마다 별도의 파일을 싣다 보면 금세 커집니다. 가변 글꼴 하나로 합치고 실제로 사용하는 글자만 남기자 이 블로그에서는 내려받는 글꼴의 크기가 절반 이하로 줄었습니다.
대신 서브셋에는 대가가 따릅니다. 남길 글자를 정한다는 것은 그 밖의 글자를 새로 쓰면 깨질 수 있다는 뜻이고, 글자 집합뿐 아니라 글꼴이 가진 기능도 함께 빠질 수 있습니다. 문제는 이런 기능이 없어져도 오류가 나지 않는다는 것입니다. 증상은 "목록의 날짜 열이 조금씩 어긋난다" 정도로만 나타날 수 있습니다. 무엇이 남았는지는 추측하기보다 실제 파일을 확인하는 편이 낫습니다.
이미지는 크기뿐 아니라 언제 가져오느냐도 중요합니다. 첫 화면에 바로 보여야 하는 이미지라면 다른 자원보다 늦게 요청되지 않는지 확인해야 합니다. 최적화 속성을 추가했다면 프레임워크를 거쳐 실제 HTML에도 원하는 형태로 출력됐는지 다시 확인합니다.
널리 알려진 처방이 내 사이트에서도 항상 이득인 것은 아닙니다. 미리 받아 두라는 지시는 대역폭 자체를 늘려 주지 않습니다. 브라우저가 이미 즉시 발견할 수 있는 자원이라면 효과가 없고, 당장 필요하지 않은 자원을 먼저 받게 하면 오히려 중요한 자원의 차례를 빼앗을 수도 있습니다. 적용한 뒤 다시 재지 않으면 이런 역효과는 알 수 없습니다.
무게를 그대로 받아들이는 것도 성능 작업입니다. 이 블로그의 사이트 내 검색 인덱스는 글꼴보다 훨씬 크지만 그대로 두고 있습니다. 첫 화면에서 내려받는 것이 아니라 실제로 검색할 때만 필요하기 때문입니다. 전체 전송량보다 사용자가 처음 화면을 보기까지 어떤 자원이 필요한가를 기준으로 성능 예산을 잡았습니다.
여기까지 오면서 가장 크게 영향을 준 것은 측정 조건이었습니다. 로컬 미리보기와 실제 운영 환경은 압축이나 캐시 같은 조건이 다를 수 있습니다. 조건을 맞추지 않은 채 숫자만 비교하면 운영에는 없는 문제를 고치게 됩니다.
10. 측정과 데이터 분석
측정 도구를 붙이는 일 자체는 어렵지 않습니다. 그 뒤부터는 무엇을 어떻게 측정할 것인가를 정해야 합니다.
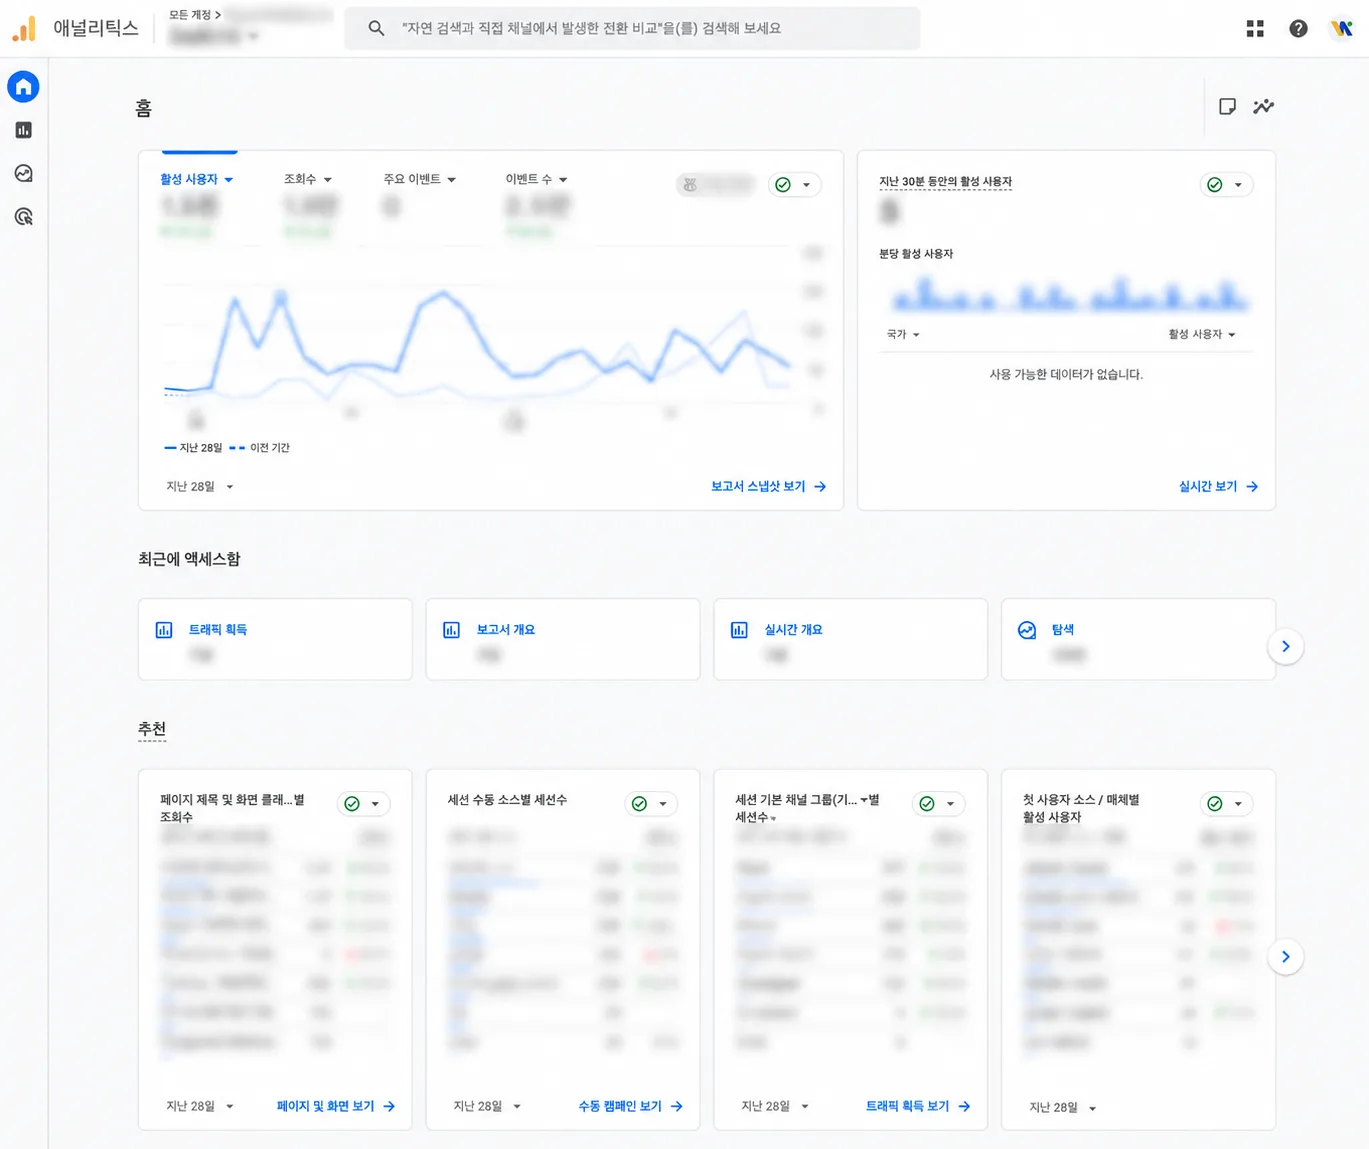
먼저 유입 경로를 구분하는 규칙입니다. 캠페인 링크에 붙이는 값은 이후 보고서에서 유입을 분류하는 기준이 됩니다. 같은 채널을 서로 다른 이름으로 적거나 오타가 섞이면 하나여야 할 유입이 여러 항목으로 갈라집니다. 그래서 사용할 값을 한곳에 모아 두고, 정해 둔 범위를 벗어난 값은 검사에서 막도록 했습니다.
반대로 사이트 안의 링크에는 캠페인 식별자를 붙이지 않습니다. 외부에서 들어온 경로를 구분하려는 값이 내부 이동에서 다시 붙으면, 사용자가 어디에서 처음 들어왔는지 해석하기 어려워집니다.
지표를 보는 화면을 직접 만들면 편해지는 대신 검증할 것이 하나 늘어납니다. 지표의 정의뿐 아니라 그 지표를 계산하는 코드도 틀릴 수 있습니다.
이 블로그의 통계 화면은 한때 최근 2주 동안 세션이 늘었다고 표시했습니다. 그런데 같은 응답에 들어 있던 일별 값을 직접 더해 보니 실제로는 줄어 있었습니다. 두 기간의 총계를 행의 순서만 보고 구분하고 있었는데, 그 순서는 보장되는 값이 아니었습니다. 우연히 예상한 순서로 응답이 올 때는 문제가 드러나지 않았습니다.
그래서 가능하면 하나의 숫자를 다른 방법으로 한 번 더 확인합니다. 총계와 일별 값의 합이 어긋난다면 숫자를 해석하기 전에 데이터를 만드는 코드부터 확인합니다.
측정에는 한계도 있습니다. 제 방문 역시 같은 데이터에 들어옵니다. 글을 고치면서 여러 번 새로고침한 것과 독자가 실제로 읽은 것이 그대로 섞일 수 있습니다. 숫자를 볼 때는 무엇을 측정했는지만큼 무엇이 함께 섞여 있는지도 알아야 합니다.
Recap
이 단원에서 하는 일은 다음에 무엇을 고칠지 결정하는 것입니다. 그래서 숫자 자체보다 그 숫자가 어떤 조건에서 만들어졌는지를 먼저 확인해야 합니다.
성능은 같은 조건에서 변경 전후를 비교해야 하고, 분석 데이터는 무엇을 어떤 기준으로 집계했는지 알아야 합니다. 직접 만든 측정 도구라면 지표뿐 아니라 그 지표를 만드는 코드까지 검증 대상이 됩니다.
특히 조심할 것은 우연히 맞는 결과입니다. 한 번 기대한 숫자가 나왔다고 해서 계산 방법까지 맞는 것은 아닙니다. 조건을 바꿔 보고 다른 값과 교차 검증해 봐야 그제야 다음 판단에 사용할 수 있는 숫자가 됩니다.
그래서 왜 직접 운영해볼 만한가
개인 블로그를 직접 운영한다고 해서 갑자기 더 좋은 개발자가 되는 것은 아닙니다. 다만 평소에는 이미 정해진 채로 만나는 것들을, 아주 작은 규모에서 처음부터 끝까지 직접 결정해 볼 수 있습니다.
회사에서 일하면 주소 체계도, 배포 방식도, 캐시 정책도, 분석 도구도 대부분 이미 정해져 있습니다. 문제가 생겨도 내가 손대는 범위는 일부인 경우가 많습니다. 반면 작은 개인 서비스에서는 어디까지를 기본값에 맡길지부터 직접 정해야 합니다.
처음에는 대부분 그냥 둡니다. 그러다 글이 쌓이고 사람이 들어오고, 뭔가 하나씩 어긋나기 시작하면 그제야 이유를 찾아보게 됩니다. 왜 대표 주소를 따로 정해야 하는지, 왜 경고만 띄우면 안 되는지, 왜 댓글은 저장됐는데 보이지 않는지, 왜 숫자는 맞는 것처럼 보이는데 실제로는 틀릴 수 있는지 같은 것들입니다.
이런 문제를 하나씩 겪다 보면 기술 하나를 더 배우는 데서 끝나지 않습니다. 웹 서비스가 왜 지금 같은 구조와 규칙을 갖게 되었는지를 직접 겪으며 이해하게 됩니다.
재미있는 건 대부분 사이트를 처음 만들 때는 보이지 않았다는 점입니다. 글이 늘어나면 콘텐츠 규칙이 필요해지고, 유입이 생기면 검색과 측정을 보게 되고, 기능이 붙으면 배포와 보안이 따라옵니다. 필요가 생긴 뒤에 찾아본 지식이라 훨씬 구체적으로 남았습니다.
전부 직접 구현할 필요도 없습니다. 저도 1년 8개월 동안 필요해질 때마다 하나씩 손댔습니다. 모든 영역을 직접 만드는 것보다, 내 서비스가 어떤 선택과 기본값 위에서 돌아가는지 알고 있는 것이 낫다고 생각합니다.
그래서 글을 계속 쓸 생각이 있다면 개인 블로그를 직접 운영해 보기를 추천합니다. 글을 올릴 공간 하나를 얻는 것보다, 작은 서비스를 만들고 운영하고 고치는 과정을 오래 반복해 볼 수 있다는 점이 훨씬 큽니다.
블로그가 아니어도 비슷한 경험은 할 수 있습니다. 다만 이미 꾸준히 만들 콘텐츠가 있는 사람에게는, 개인 블로그가 이 과정을 가장 자연스럽게 오래 굴려 볼 수 있는 서비스 중 하나입니다.
이 블로그의 기술 스택
| 영역 | 쓰는 것 |
|---|---|
| 콘텐츠와 표현 계층 | Docusaurus 3.8, React 18, TypeScript, MDX, Mermaid, KaTeX, Prism |
| 정보 구조와 검색 | 사이트 내 검색(한국어·영어 색인), RSS·Atom 피드, Google Search Console, 네이버 서치어드바이저 |
| 빌드와 자동화 | Yarn 4, Node 22, lefthook, GitHub Actions |
| 호스팅과 배포 | Netlify, AWS Route 53, GitHub |
| 백엔드와 서버리스 | Netlify Edge Functions, Netlify Functions, Netlify Blobs |
| 댓글 기능 | giscus와 GitHub Discussions |
| 보안과 접근 제어 | GitHub OAuth |
| 성능 측정 | Lighthouse |
| 데이터 분석 | Google Analytics 4, GA4 Data API 연동 서버리스 |
References
- 이 블로그를 운영하며 배운 SEO: 주소 정규화, 사이트맵과 색인 정책, 구조화 데이터를 이 사이트의 설정과 결과로 정리한 글
정보 구조와 검색 노출
- How to Specify a Canonical with rel="canonical": 같은 내용이 여러 주소로 열릴 때 대표 주소를 지정하는 방법과, 지정하지 않으면 검색엔진이 스스로 고른다는 설명
- Block Search Indexing with noindex: 색인에서 빼는 표시를 크롤러가 읽어야 효과가 있다는 조건
- Robots.txt Introduction and Guide: 크롤링을 막는 것이 색인에서 빼는 것과 다른 이유
- What Is a Sitemap: 사이트맵이 알려 주는 것과 색인을 보장하지 않는다는 점
- RSS 2.0 Specification: 리더가 새 항목을 판별하는 데 쓰는
guid의 정의
전달과 방어
- HTTP caching (MDN):
max-age와 재검증의 동작, 이름이 바뀌는 자산과 그렇지 않은 자산의 구분 - hydrateRoot (React): 서버가 그린 HTML과 첫 클라이언트 렌더가 일치해야 하는 이유와 어긋났을 때의 동작
- Server Side Request Forgery Prevention Cheat Sheet (OWASP): 사설 대역 차단, 이름 해석 시점과 접속 시점의 분리, 리다이렉트 재검증
성능과 측정
- Largest Contentful Paint (LCP): 무엇이 LCP 요소가 되는지와 대기 구간의 분해
- Optimize resource loading with the Fetch Priority API: 우선순위 지정이 미리 받게 하는 지시와 어떻게 다른지
- subset (fontTools): 서브셋 생성 옵션과, 지정하지 않으면 남지 않는 글꼴 기능 목록
- Default channel group: 채널이 인식하는 매체 값과 그 밖의 값이 빠지는 자리
- Create a report (GA4 Data API): 두 기간을 한 번에 요청할 때 응답에 붙는 기간 구분
- GA4 Data API quotas: 속성당 동시 요청 한도와 429 응답