API 응답은 모델을 닮아야 할까요?
응답 스펙을 정하다가 손이 멈췄습니다. 모델에는 병역이 하나의 묶음(nested)으로 들어 있는데, 응답도 그 모양 그대로 내보내면 되는 걸까? 아니면 클라이언트가 쓰기 좋은 모양으로 따로 설계해야 하나? 어느 쪽이 정답인지 물었더니 이번에도 답은 "규칙이 아니라 선택"이었습니다. 어느 쪽을 골라도 감당할 비용이 있었습니다.
API 응답은 도메인 모델을 닮아야 할까요, 아니면 자기만의 모양을 가져야 할까요?
이 글에서 다루는 내용
지난 글에서 호출자를 정했다면, 이번에는 모델과 응답의 결합 정도, 경계별 DTO, 인터페이스로 필드 누락을 잡는 방법을 살펴봅니다. 프론트엔드에서 익숙한 리소스 중심 API와 뷰모델 사이의 선택이 그대로 이어집니다.
규칙이 아니라 트레이드오프입니다
모델과 Response의 모양을 맞출지는 아키텍처 규칙이 아니라 비용을 비교해 고르는 선택입니다.
| 전략 | 얻는 것 | 내는 비용 |
|---|---|---|
| 맞춘다 (모델 shape ≈ Response shape) | 매핑 비용 감소, 클라이언트가 모델의 생김새를 인식, 관리의 일관성 | 계약이 모델에 결합되어 모델 리팩토링 = 계약 변경이 된다 |
| 분리한다 (Response는 독립 설계) | 모델과 계약이 각자의 속도로 진화 | 매핑 레이어의 유지 비용 |
프론트엔드에서도 리소스 기반 REST와 화면 종속 응답(BFF·뷰모델) 사이에서 같은 고민을 합니다. 한쪽을 원칙으로 세우기보다 "이 API는 모델을 따른다" 혹은 "이 API는 화면을 따른다"고 기록해 두어야 다음 변경에서도 기준이 흔들리지 않습니다.
이때 같은 정보를 다루는 것과 JSON 구조까지 같게 만드는 것을 구분해야 합니다. 병역의 사항·종류·복무 기간이라는 필드의 의미는 공유하면서도, 모델에서는 하나로 묶고 응답에서는 낱개로 펼칠 수 있습니다. 어떤 필드를 공유할지와 어떤 구조로 전달할지를 따로 정하는 것입니다.
경계마다 다른 데이터 표현
병역 데이터의 표현을 계층별로 보겠습니다. 도메인 안에서는 nested 값객체 하나로 묶고, 공개 API 계약에서는 flat한 4개 필드로 펼칩니다. 같은 정보를 전달하되 응답 구조는 모델과 분리한 예입니다.
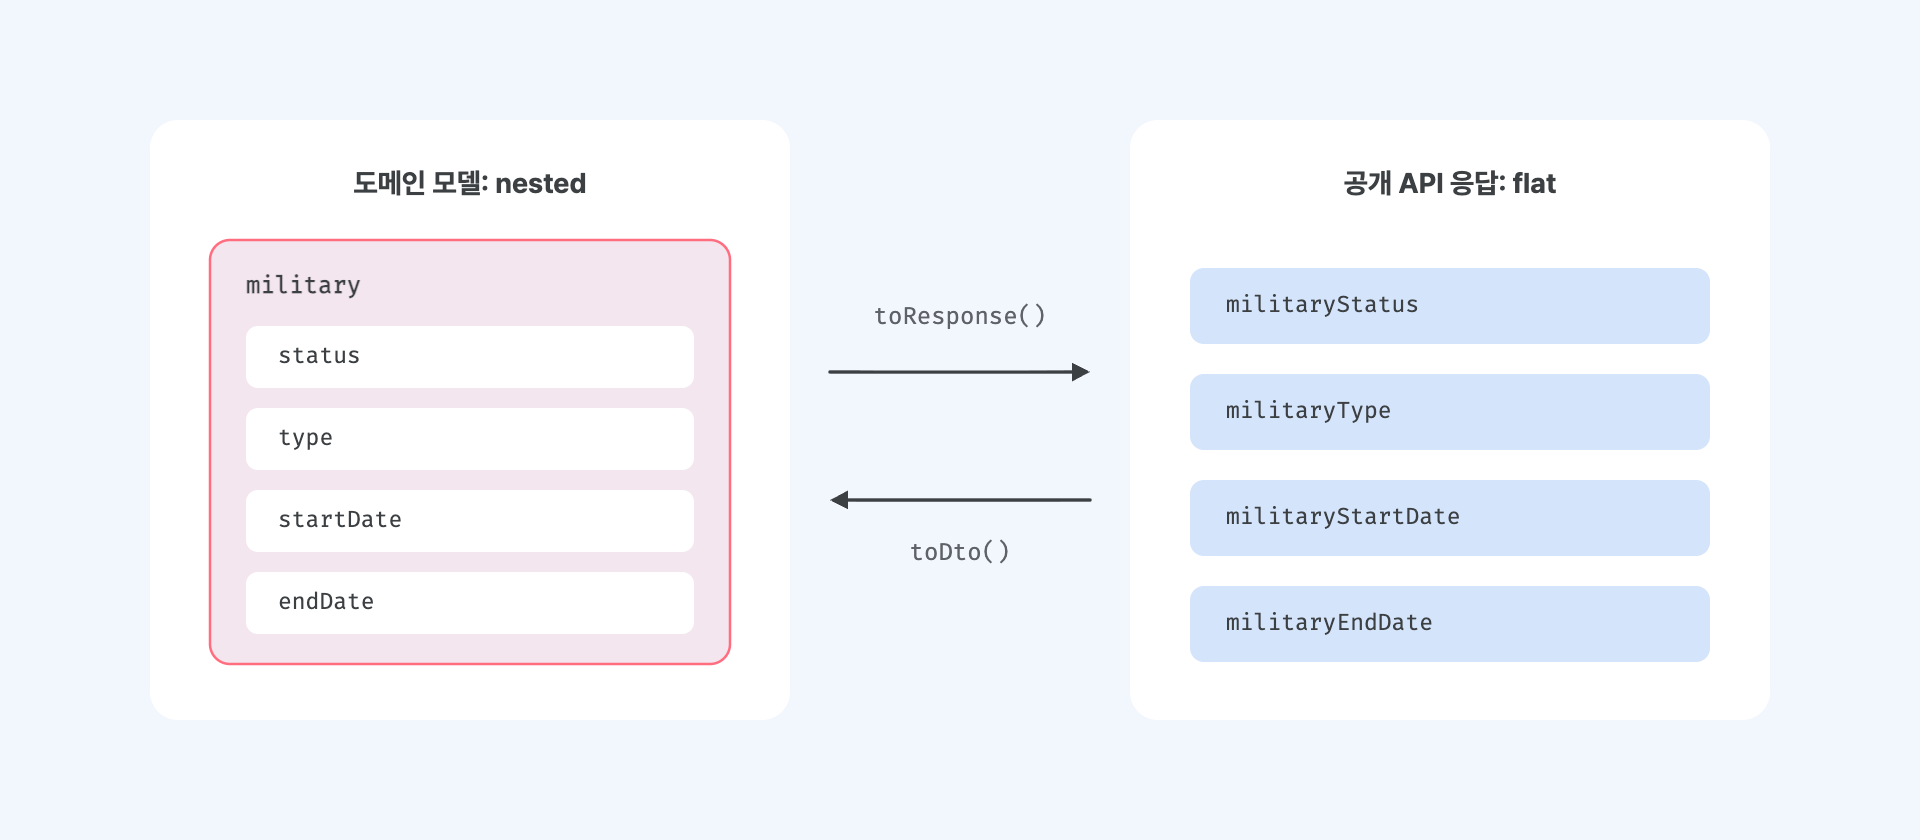
도메인에서 묶는 이유는 3편에서 본 정합성 규칙("복무 기간은 군필/복무중일 때만")을 함께 검사하기 위해서입니다. 공개 계약은 클라이언트 폼과 응답 소비 코드가 낱개 필드를 다루므로 flat하게 둡니다. toResponse()·toDto() 같은 함수가 두 표현 사이를 변환합니다.
프론트엔드에서도 서버 응답 타입, 화면 뷰모델, 폼 상태를 각각 매핑합니다. 1편에서 봤던 "필드 하나에 파일 열 개" 가운데 상당수가 바로 이런 경계별 표현과 변환 함수들입니다.
전파를 컴파일러에게 맡기는 선택
계층마다 표현이 따로 있으면 걱정이 하나 생깁니다. 모델에 필드를 추가했는데 DTO나 Response에서 빠뜨리면? 응답에서 조용히 필드가 누락된 채 배포되면?
필드 구조를 공유하기로 한 계층에서는 인터페이스 구현 강제를 쓸 수 있습니다. 모델의 인터페이스를 DTO·Entity·Response가 구현(implement)하게 하면, 필수 필드를 추가했을 때 그 필드가 없는 구현체에서 컴파일 에러가 납니다. 앞의 flat/nested 변환처럼 구조를 분리한 경우에는 같은 인터페이스를 모든 표현에 강제할 수는 없습니다.
interface UserProfile { military: MilitaryService }         // 모델에 필드 추가
class UserProfileDto implements UserProfile { /* ... */ }   // → 즉시 컴파일 에러
interface UserProfile { val military: MilitaryService }

class UserProfileDto(
    override val military: MilitaryService, // override가 강제된다: 빠뜨리면 빌드 실패
    /* ... */
) : UserProfile
TypeScript에서 매일 겪는 바로 그 메커니즘입니다. Kotlin에는 장치가 하나 더 있습니다. else 없는 when은 enum의 모든 값을 다뤄야 합니다. 표현식으로 쓰는 when은 처음부터 그랬고, 문(statement)으로 쓰는 when도 Kotlin 1.7부터는 누락이 경고가 아니라 컴파일 에러입니다. ProfileColumn 값을 추가하면 해당 값을 처리하지 않은 else 없는 when 분기가 컴파일 오류로 드러납니다.
// enum에 MILITARY를 추가하는 순간, else 없는 when은 전부 컴파일 에러가 난다
when (column) {
    ProfileColumn.NAME -> applyName(request)
    ProfileColumn.BIRTH_DATE -> applyBirthDate(request)
    // ProfileColumn.MILITARY 분기를 추가하기 전엔 빌드가 멈춘다
}
TypeScript의 discriminated union에 never 체크를 두어 분기 누락을 잡는 것과 같은 원리입니다.
이것 역시 공짜가 아닙니다. 필드 누락이 컴파일 단계에서 드러나는 대신 모델과 구현체를 한 변경에서 함께 고쳐야 합니다. 필드 하나를 추가한 제 PR이 커질 수밖에 없었던 이유가 여기에 있었습니다. 이 구조는 작은 변경보다 누락을 빨리 발견하는 쪽을 택했습니다.
다음 글에서는 부분 수정 요청에서 null과 필드 생략을 구분하는 방법을 다룹니다.
FE ↔ BE 대응표
이 글에서 다룬 대응입니다.
| BE 개념 | FE에서 가장 가까운 것 | 대응의 핵심 |
|---|---|---|
| 모델 ↔ Response 정합 | 리소스 REST vs 뷰모델 논쟁 | 서버에서 하는 같은 고민, 결정하고 기록한다 |
| DTO 레이어링 (flat ↔ nested) | 응답 타입·뷰모델·폼 상태 어댑터 | 경계마다 자기 표현, 변환은 경계에서 |
| 인터페이스 구현 강제 | implements + 컴파일 에러 | 전파를 컴파일러에게 맡긴다 |
exhaustive when | discriminated union + never 체크 | 분기 누락을 타입 시스템이 잡는다 |
References
DTO와 계약
- Martin Fowler: Data Transfer Object (P of EAA)
- Ian Robinson: Consumer-Driven Contracts (martinfowler.com)
타입 시스템의 전파 강제