도메인 모델은 왜 DB를 몰라야 할까요?
처음 백엔드 레포를 열었을 때 가장 먼저 든 생각은 "필드 하나 추가하는데 왜 파일을 열 개나 고치지?"였습니다. 모델, 엔티티, DTO, Request, Response까지 비슷하게 생긴 클래스가 모듈마다 하나씩 있고 같은 필드가 곳곳에 반복됩니다. 처음엔 중복으로 보였는데 작업을 끝내고 나니 그 반복이 실수가 아니라 이 구조의 의도였습니다. 그 의도를 이해하는 열쇠가 바로 "모델이 중심"이라는 말이었습니다.
백엔드는 왜 모델을 중심에 놓고, 모델은 왜 DB를 모르는 채로 두는 걸까요?
이 글에서 다루는 내용
이 글은 헥사고날 아키텍처(hexagonal architecture)의 가장 기초가 되는 아이디어, 도메인 모델을 시스템의 중심에 놓고 순수하게 유지하는 것을 다룹니다. 백엔드를 처음 접하는 분, 특히 저처럼 프론트엔드에서 넘어온 분을 독자로 상정하고, 새 개념이 나올 때마다 프론트엔드에서 이미 쓰고 있는 개념에 대응시켜 설명하겠습니다. JPA가 뭔지 몰라도 따라올 수 있습니다. 저도 이 작업을 시작할 때 몰랐습니다.
모델은 순수합니다
백엔드 아키텍처 자료를 읽다 보면 헥사고날 아키텍처, 포트와 어댑터(ports & adapters), 클린 아키텍처(clean architecture) 같은 이름이 계속 나옵니다. 이름은 여러 개지만 핵심 아이디어는 하나입니다.
시스템의 중심에 도메인 모델(domain model)을 놓는다. 모델은 업무의 개념과 규칙만 표현하고, DB·프레임워크·프로토콜을 전혀 모른다.
여기서 "모른다"는 문자 그대로입니다. 모델 코드 어디에도 SQL이 없고, HTTP가 없고, 어떤 데이터베이스 라이브러리의 import도 없습니다. 처음엔 이 말이 이상하게 들렸습니다. 데이터를 저장하고 꺼내는 게 백엔드의 일 아닌가? 그런데 이 구조에서 영속성(persistence)은 모델의 속성이 아니라 모델 바깥에 나중에 붙이는 부품입니다. JPA를 쓰든 JDBC를 쓰든 아예 다른 저장소로 갈아타든, 모델은 한 줄도 바뀌지 않습니다. 저장소를 갈아끼울 수 있는 것은 모델이 어느 저장 기술에도 묶여 있지 않기 때문입니다.
다만 이 구조의 값어치를 "언젠가 DB를 갈아끼울 수 있다"에서만 찾으면 절반만 본 것입니다. 솔직히 실무에서 DB를 통째로 교체하는 일은 드뭅니다. 더 일상적인 이점은 테스트 가능성입니다. 진짜 DB를 띄우지 않고도 코어의 업무 규칙을 검증할 수 있고, 바깥 기술의 유행이 바뀌어도 도메인 코드가 흔들리지 않습니다. 이 구조를 제안한 Alistair Cockburn의 원래 동기도 교체가 아니라 이쪽, 바깥세상과 격리된 채 개발하고 테스트할 수 있는 애플리케이션이었습니다.
React 코어와 렌더러
React 코어와 렌더러의 관계를 떠올리면 이 구조를 이해하기 쉽습니다.
React의 reconciler는 렌더러가 제공하는 host config를 통해 실제 노드를 만들고 갱신합니다. 공통 조정 로직을 공유하면서 react-dom, React Native, @react-three/fiber가 각각 DOM, 네이티브 뷰, 3D 오브젝트를 다룹니다. 다만 reconciler는 상태와 스케줄링을 관리하므로 여기서 말하는 순수 도메인 모델과 같은 것은 아닙니다.
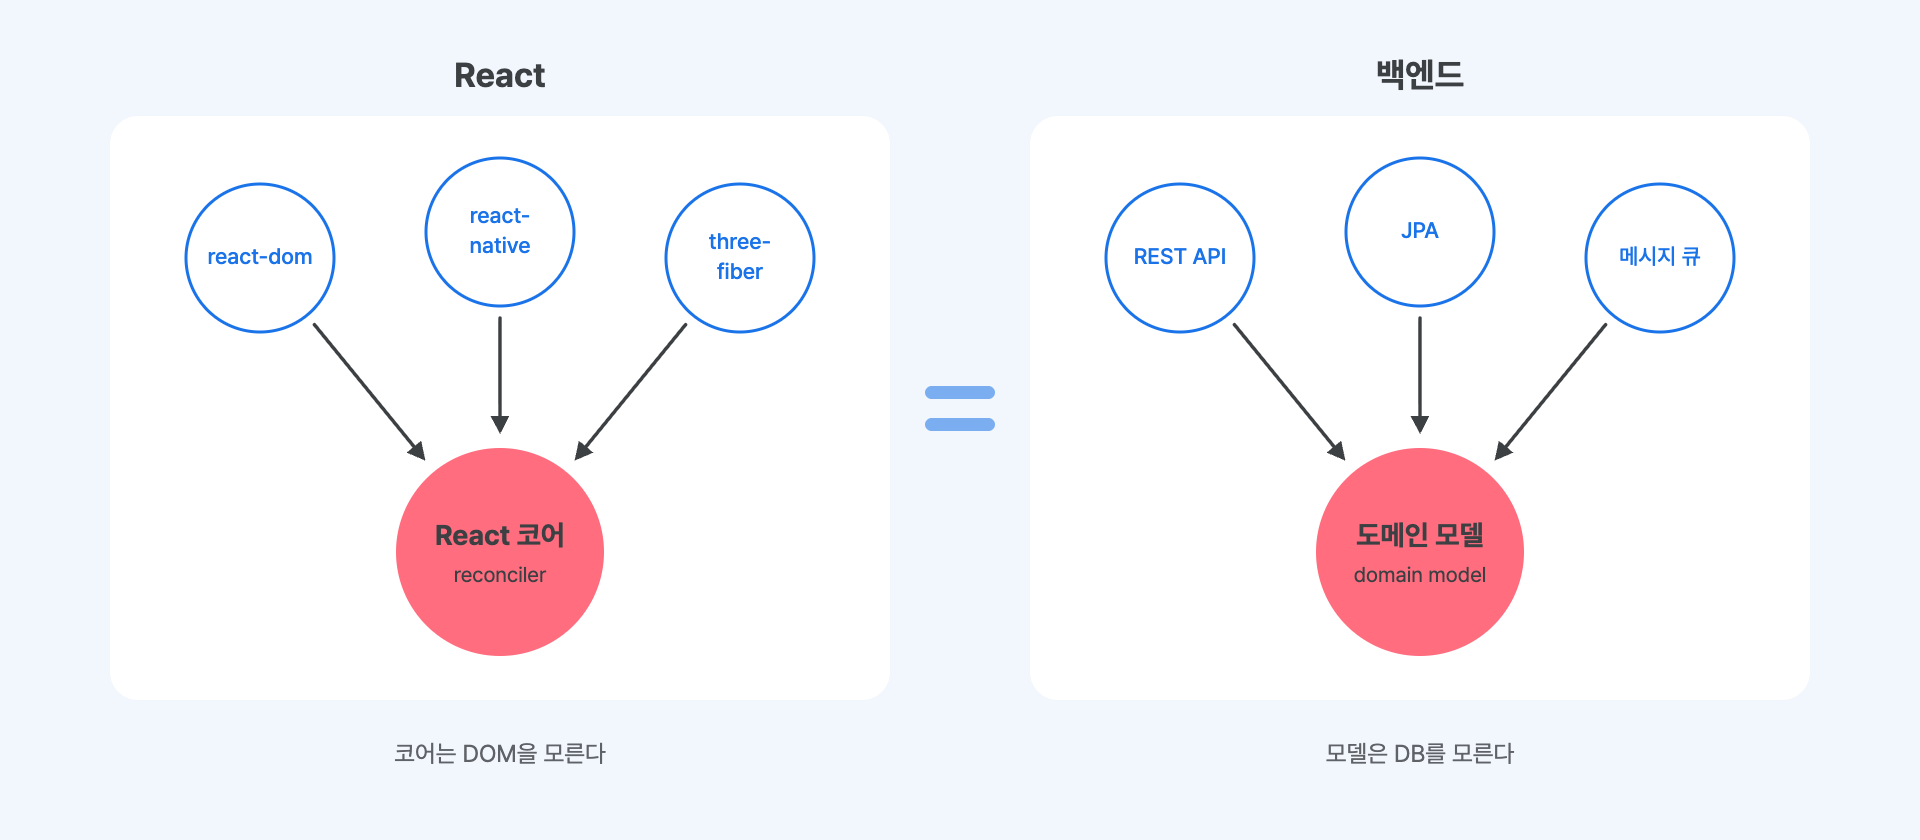
여기서 닮은 부분은 실제 출력이나 저장을 바깥 구현에 맡기는 것입니다. 도메인 모델을 React 코어에, 저장소 어댑터를 렌더러에 대응시켜 볼 수 있습니다. 이 비유로 보면 저장소 코드가 모델을 참조하고 모델은 저장소 코드를 참조하지 않는 방향이 조금 더 익숙해집니다.
아래 화살표는 런타임의 호출 방향입니다. 코어가 바깥 어댑터를 호출하더라도 소스 코드에서는 코어가 선언한 포트에 의존합니다.
다이어그램의 화살표는 호출(제어)의 방향입니다. 바깥을 모른다면서 코어에서 어댑터로 화살표가 나가는 게 모순처럼 보일 수 있는데, 호출의 방향과 의존의 방향은 다른 것입니다. 이 갈라짐은 경계를 지키는 것은 폴더가 아니라 빌드입니다에서 다시 다룹니다.
가운데에 모델과 유즈케이스(use case)가 있고, REST API·DB·메시지 큐 같은 바깥세상과의 접점은 전부 어댑터(adapter)로 밀려나 있습니다. 헥사고날이라는 이름의 육각형은 별 뜻이 없습니다. 어댑터가 여러 면에 붙을 수 있다는 것을 그림으로 표현하다 보니 육각형이 됐을 뿐이라고 Cockburn 본인이 밝히고 있습니다.
Recap
도메인 모델에는 업무의 개념과 규칙을 두고 DB 접근은 바깥의 어댑터에 맡깁니다. 모델 코드가 DB나 프레임워크를 참조하지 않으면 실제 저장소 없이도 업무 규칙을 테스트할 수 있습니다. 저장 기술을 바꿀 때도 그 변경을 어댑터 쪽에 모을 수 있습니다.
갈아끼움을 가능하게 하는 것, 인터페이스
그런데 모델이 DB를 모른다면 저장은 대체 누가, 어떻게 할까요? 여기서 등장하는 메커니즘이 인터페이스입니다. 헥사고날 용어로는 포트(port)라고 부릅니다.
코어 쪽은 "저장할 수 있다"는 계약만 선언합니다. 구현은 바깥에 삽니다.
// 코어 모듈: 모델은 인터페이스(포트)만 안다
interface UserProfileRepository {
    fun find(userId: UserId): UserProfile?
    fun save(profile: UserProfile)
}
// 어댑터 모듈: JPA 구현. 갈아끼우는 부품
class UserProfileJpaRepository(...) : UserProfileRepository { ... }
이 패턴은 프론트엔드에서 늘 하던 것과 같은 방식입니다.
// 소비하는 쪽은 "저장할 수 있다"는 계약만 안다
interface ProfileStorage {
  load(): Profile;
  save(p: Profile): void;
}
// localStorage 구현이든 IndexedDB 구현이든 소비하는 쪽은 모른다
왜 모델부터 설계할까
포트가 갈아끼움을 가능하게 한다면, 설계의 순서가 모델을 지켜줍니다. 영속성부터 붙이고 시작하면 자연스럽게 "모델 = DB 로우(row)"라고 생각하게 됩니다. 테이블 구조가 먼저 있고 그 위에 코드를 얹는 식이 되는 것입니다.
프론트엔드로 번역하면 이것은 서버 응답 shape을 그대로 뷰모델로 쓰는 것과 같은 문제입니다. 화면에 필요한 것 대신 서버 응답이나 테이블 구조 같은 바깥 사정이 설계를 좌우하게 됩니다. 응답 구조가 바뀔 때마다 컴포넌트를 고쳐야 했던 분이라면 그 비용을 이미 알고 계실 것입니다.
그래서 순서가 중요합니다. 영속성을 일단 잊고 모델부터 설계합니다. 예를 들어 사용자 프로필에 병역 정보를 추가한다면, "병역이란 사항·종류·복무 기간으로 이루어진 하나의 개념 묶음이다"라는 정의가 먼저고, 그것이 개별 컬럼에 저장될지 JSON 컬럼 하나에 저장될지는 그 뒤에 따로 내릴 결정입니다. 저장 형태는 어댑터의 사정이고 주(主)는 모델입니다.
요청 하나가 지나가는 길
이제 구조의 정적인 그림은 잡혔으니, 실제 요청 하나가 이 구조를 어떻게 통과하는지 따라가 보겠습니다. 모든 요청은 어댑터로 들어와서 유즈케이스를 지나 모델을 만나고, 다시 유즈케이스와 어댑터를 지나 나갑니다.
API ── 어댑터 ── 유즈케이스 ── (모델) ── 유즈케이스 ── 어댑터 ── DB
조회 요청을 예로 풀면 이렇게 됩니다.
눈여겨볼 것은 DB에서 나온 row가 그대로 흘러가지 않고 어댑터에서 모델로 복원된 뒤에야 안쪽으로 들어간다는 점, 그리고 나갈 때도 모델이 그대로 나가지 않고 Response 전용 표현(DTO) 으로 바뀌어 나간다는 점입니다. 층마다 자기 표현이 있습니다.
예를 들어 프로필 응답에 다른 모델의 정보를 합치거나 모델의 일부 필드만 내보낼 수도 있습니다. DB에서 읽은 형태, 업무 규칙을 적용할 형태, 클라이언트에 보낼 형태를 각각 정하는 것입니다.
경계를 지키는 것은 폴더가 아니라 빌드입니다
마지막으로 서두의 의문, "필드 하나 추가하는데 왜 파일을 열 개나 고치지?"로 돌아가겠습니다.
이런 구조의 백엔드 레포를 열어보면 한 도메인이 여러 개의 Gradle 모듈로 쪼개져 있습니다. 이름은 팀마다 다르지만 나누는 축은 비슷합니다. 이 글에서는 아래처럼 부르겠습니다.
| 모듈 | 역할 | FE로 치면 |
|---|---|---|
:model | 순수 도메인 모델·값객체·enum. 외부 의존 없음 | 타입 + 헤드리스 도메인 로직 패키지 |
:contract | 서비스 인터페이스와 DTO 계약 | API 계약 (인터페이스) |
:repository | JPA 엔티티와 컨버터(DB 어댑터) | ORM·직렬화 계층 |
:service | 비즈니스 로직 구현체 | 상태 관리·오케스트레이션 계층 |
:api | REST 컨트롤러와 Request/Response | 라우트 핸들러 + 응답 타입 |
모듈은 폴더가 아니라 빌드 단위로 나뉩니다. 모듈 간 의존은 빌드 설정에 명시되고 방향은 안쪽(:model)으로만 향합니다. 프론트엔드 모노레포에서 디자인시스템 패키지가 앱 코드를 import할 수 없는 것과 같은 방향 그래프인데, 이걸 lint 규칙이 아니라 컴파일 자체가 안 되는 수준에서 강제합니다. 모델이 어댑터를 참조하는 코드는 리뷰어가 잡아내기 전에 빌드가 먼저 거부합니다.
앞의 병역 정보 예제를 이 모듈 구분에 대입해 보겠습니다. 모델에는 병역의 필드와 규칙을 추가하고, 리포지토리에는 저장 형태와 변환 코드를 추가합니다. API에는 요청으로 받을 값과 응답으로 내보낼 값을 정합니다. 그래서 필드 하나를 추가해도 여러 파일을 고치게 됩니다. 대신 DB 저장 형태만 바뀔 때는 API 응답까지 함께 바꾸지 않을 수 있습니다.
한 가지 의문이 남습니다. 코어는 런타임에 분명히 DB를 쓰는데 의존은 안쪽으로만 향한다니, 호출의 방향과 의존의 방향이 어긋나 있습니다. 이 모순을 푸는 것이 의존성 역전(DIP, Dependency Inversion Principle)인데, 인바운드/아웃바운드 어댑터의 구분과 함께 다음 글에서 다루겠습니다.
FE ↔ BE 대응표
이 글에서 다룬 대응만 추려 정리합니다. 시리즈가 진행되면서 이 표는 계속 늘어날 예정입니다.
| BE 개념 | FE에서 가장 가까운 것 | 대응의 핵심 |
|---|---|---|
| 도메인 모델 | React 코어 / 헤드리스 로직 | 순수한 중심, 바깥을 모름 |
| 어댑터 | 렌더러 (react-dom 등) | 갈아끼울 수 있는 바깥 부품 |
| 포트 (인터페이스) | 스토리지 인터페이스 계약 | 계약은 안쪽이 소유한다 |
| DTO / Response | API 응답 타입 · 뷰모델 | 경계를 건너는 전용 표현 |
| 모듈 의존 방향 | 모노레포 import 방향 | 빌드가 강제하는 방향 그래프 |
References
헥사고날 아키텍처
- Alistair Cockburn: Hexagonal Architecture
- Herberto Graça: Ports & Adapters Architecture
- Netflix Tech Blog: Ready for changes with Hexagonal Architecture
클린 아키텍처와 레이어링
React 코어와 렌더러