ETL이란 무엇인가요? 데이터를 옮기는 세 단계
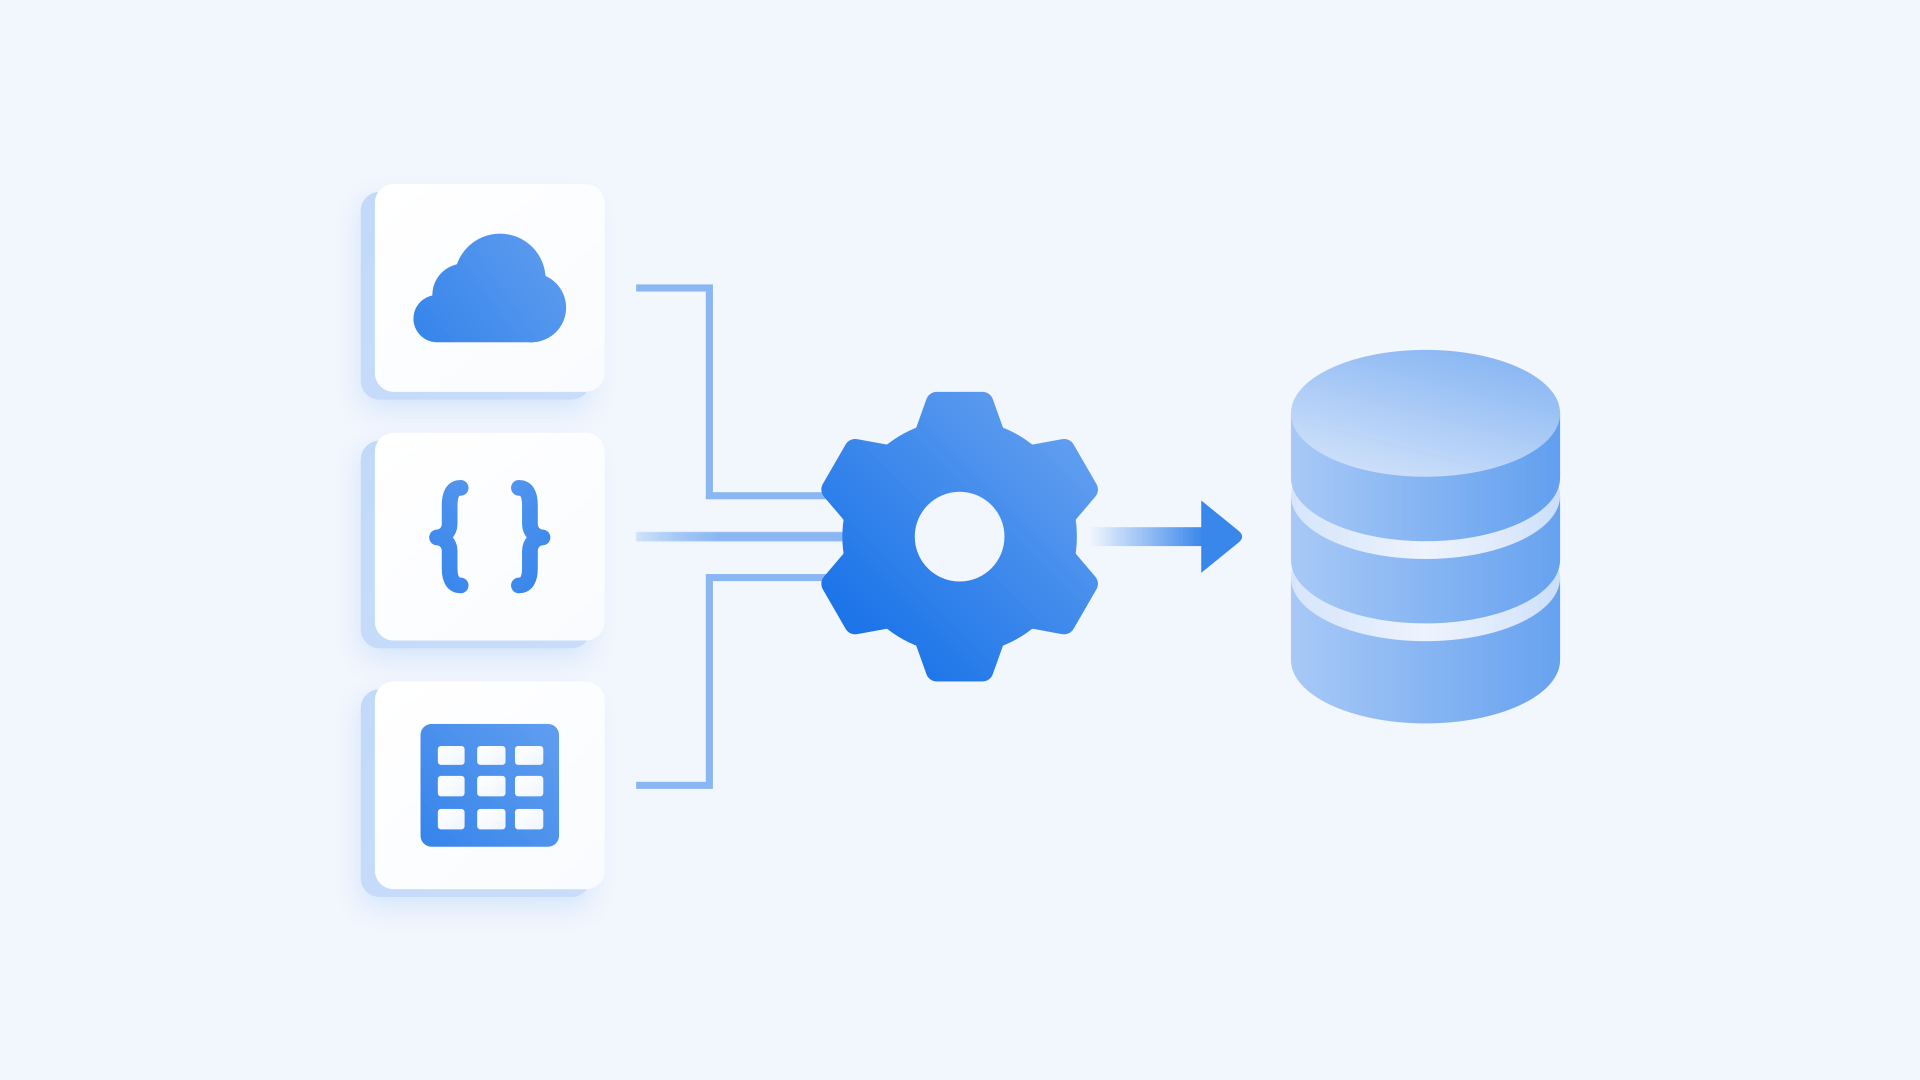
회사에서 고객사의 데이터를 새로운 시스템으로 옮기는 제품을 만든 적이 있습니다. 구성원이나 조직처럼 비교적 익숙한 데이터부터 계약, 발령처럼 서로의 관계가 중요한 데이터까지 종류도 다양했습니다. 문제는 같은 의미를 가진 데이터라도 고객사마다 모습이 달랐다는 점입니다.
어떤 곳에서는
employee_id라고 부르는 값을 다른 곳에서는사번이라고 부릅니다. 날짜는2026-05-01일 수도 있고2026.05.01일 수도 있습니다. 같은 상태를재직,Y,1처럼 서로 다른 값으로 표현하기도 합니다. 기존에는 이런 차이를 사람이 엑셀을 열어 하나씩 맞추고, 잘못된 값을 고치고, 다시 업로드하는 방식으로 처리하고 있었습니다.이 일을 제품으로 옮기면서 데이터를 가져오고, 우리가 쓰는 형태로 바꾸고, 잘못된 데이터를 찾아내고, 새 시스템에 저장하는 흐름을 만들게 되었습니다. 정리하다 보니 그 흐름은 ETL(Extract, Transform, Load)이라는 구조와 맞닿아 있었습니다.
서로 다른 시스템 사이에서 데이터를 옮길 때 무엇을 설계해야 할까요?
이 글에서 다루는 내용
ETL은 데이터 엔지니어링이나 데이터 웨어하우스 문맥에서 자주 등장하지만, 조금 넓게 보면 서로 다른 시스템 사이에서 데이터를 옮길 때 반복해서 나타나는 구조입니다. 이 글에서는 특정 제품을 만드는 방법보다, 데이터 마이그레이션을 구현하며 다시 공부하게 된 ETL의 기본 구조를 정리합니다.
- ETL의 Extract, Transform, Load가 각각 무엇을 담당하는지
- 데이터 변환에서 형식보다 의미가 중요한 이유
- 검증과 재실행을 실제 ETL에서 함께 고려해야 하는 이유
- ETL과 ELT는 무엇이 다른지
1. ETL은 무엇을 하는가
ETL은 추출(Extract), 변환(Transform), 적재(Load)의 앞글자로 만든 이름입니다.
언뜻 보면 파일을 읽어서 가공한 뒤 데이터베이스에 넣는 과정처럼 보입니다. 하지만 실제로 ETL에서 어려운 부분은 데이터를 이동시키는 것보다 서로 다른 시스템이 데이터를 해석하는 방식을 맞추는 것에 가깝습니다.
예를 들어 원본 시스템에 이런 데이터가 있다고 해보겠습니다.
이름: 홍길동
입사일: 2026.05.01
재직상태: Y
부서: 개발1팀
대상 시스템은 다음 형태를 요구할 수 있습니다.
{
  "name": "홍길동",
  "joinedAt": "2026-05-01",
  "employmentStatus": "ACTIVE",
  "organizationId": "org_123"
}
값을 그대로 복사해서는 사용할 수 없습니다. 컬럼을 연결해야 하고, 날짜 형식을 바꿔야 하고, Y라는 값을 ACTIVE라는 의미로 변환해야 합니다. 개발1팀이라는 이름은 대상 시스템에 존재하는 조직의 ID와 연결해야 할 수도 있습니다. ETL은 바로 이 차이를 다루는 과정입니다.
2. Extract: 무엇을 가져올 것인가
첫 번째 단계는 추출(Extract)입니다. 데이터베이스, API, CSV나 Excel 파일, 로그, 외부 SaaS 등 다양한 곳이 데이터의 원천(Source)이 될 수 있습니다.
여기서 단순히 데이터를 읽는 것만 생각하기 쉽지만, 실제로는 몇 가지 결정이 함께 필요합니다.
전체를 가져올 것인가, 변경된 것만 가져올 것인가
가장 단순한 방식은 원본 데이터를 매번 모두 가져오는 전체 추출(Full Extraction)입니다. 데이터가 작거나 일회성 마이그레이션이라면 충분히 사용할 수 있습니다.
반대로 데이터가 크거나 ETL이 반복적으로 실행된다면 마지막 실행 이후 변경된 데이터만 가져오는 증분 추출(Incremental Extraction)을 고려할 수 있습니다. 예를 들어 매일 수백만 건의 주문을 처리하는 시스템에서 매번 전체 주문을 다시 읽는 것은 비효율적입니다. 이 경우 다음과 같은 값을 기준으로 변경분을 찾을 수 있습니다.
SELECT *
FROM orders
WHERE updated_at > :last_extracted_at;
또는 데이터베이스에서 발생한 변경을 식별하고 캡처하는 CDC(Change Data Capture)를 사용할 수도 있습니다.
가져온 데이터를 바로 사용하지 않는 이유
ETL에서는 원본 데이터를 바로 변환하지 않고 스테이징 영역(Staging Area)에 임시로 저장하기도 합니다.
스테이징은 원본 시스템과 이후 처리 과정을 분리해줍니다. 변환 과정에서 문제가 생기더라도 원본 시스템을 다시 호출하지 않고 재처리할 수 있고, 당시 어떤 데이터가 입력되었는지 확인하기도 쉬워집니다.
ETL을 단순한 함수 하나가 아니라 재실행 가능한 데이터 처리 과정으로 보기 시작하면 이런 중간 단계의 의미가 커집니다.
3. Transform: 형태보다 의미를 맞추는 과정
ETL에서 가장 많은 일이 일어나는 곳은 보통 변환(Transform) 단계입니다. 변환이라고 하면 문자열이나 날짜 포맷을 바꾸는 작업부터 떠올릴 수 있습니다.
2026.05.01
    ↓
2026-05-01
하지만 실제 데이터에서는 조금 더 다양한 작업이 필요합니다.
스키마 매핑
서로 다른 시스템은 같은 개념에도 다른 이름을 사용합니다.
사번        → employeeNumber
입사일      → joinedAt
부서        → organization
재직 여부   → employmentStatus
따라서 원본의 어떤 컬럼이 대상 시스템의 어떤 필드와 대응하는지 정의해야 합니다.
값의 정규화
컬럼 이름만 다른 것이 아니라 값의 표현 방식도 다를 수 있습니다.
Y       → ACTIVE
재직    → ACTIVE
1       → ACTIVE

N       → TERMINATED
퇴직    → TERMINATED
0       → TERMINATED
여기서부터 ETL에는 단순한 데이터 변환을 넘어 도메인 규칙이 들어가기 시작합니다.
데이터 정리
현실의 데이터에는 빈 값이나 잘못된 값, 중복 데이터가 존재합니다.
010-1234-5678
01012345678
010 1234 5678
세 값이 같은 전화번호를 의미한다면 하나의 형태로 정규화할 수 있습니다. 중복된 레코드를 제거하거나 필요 없는 공백을 없애고, 문자 인코딩을 통일하는 작업 역시 Transform에 포함될 수 있습니다.
관계를 복원하는 일
조금 더 어려운 문제는 데이터 사이에 관계가 존재할 때 생깁니다. 예를 들어 원본 데이터에는 부서 이름만 있을 수 있습니다.
홍길동 → 개발1팀
하지만 대상 시스템은 다음처럼 ID 기반 관계를 요구할 수 있습니다.
홍길동 → org_123
그러면 먼저 개발1팀이라는 조직을 찾아 org_123이라는 식별자를 얻어야 합니다. 데이터가 서로 독립적인 행의 집합이 아니라면 ETL은 결국 관계를 다시 구성하는 작업까지 맡게 됩니다.
4. Validation: 변환됐다고 올바른 데이터는 아니다
ETL의 이름에는 들어 있지 않지만, 실제 과정에서는 검증(Validation)을 Transform과 함께 다루는 경우가 많습니다. 형식이 맞는 데이터와 업무적으로 올바른 데이터는 다르기 때문입니다.
예를 들어 다음 날짜는 문자열 형식만 보면 문제없습니다.
2026-05-01
하지만 퇴사일이 입사일보다 앞에 있다면 이야기가 달라집니다.
입사일: 2026-05-01
퇴사일: 2026-04-01
이 데이터는 문법적으로는 정상이어도 도메인 규칙에는 맞지 않습니다. 그래서 실제 ETL에서는 여러 단계의 검증이 생길 수 있습니다.
ETL을 A 형식의 데이터를 B 형식으로 바꾸는 일로만 보면 Transform까지만 보게 됩니다. 하지만 실제 시스템에 필요한 것은 B 시스템이 받아들일 수 있고, 이후에도 정상적으로 사용할 수 있는 데이터입니다.
5. Load: 저장하는 것보다 안전하게 저장하는 것
변환과 검증을 통과했다면 마지막으로 데이터를 대상 시스템에 적재(Load)합니다. 대상 범위의 데이터를 통째로 적재하는 전체 로드(Full Load)가 가장 단순하고, 이미 운영 중인 시스템에 지속적으로 데이터를 동기화한다면 변경된 데이터만 추가하거나 수정하는 증분 로드(Incremental Load)를 사용할 수 있습니다.
여기에서 새로운 문제가 생깁니다. 예를 들어 10만 건을 저장하던 중 7만 번째 데이터에서 실패했다고 해보겠습니다.
1 ~ 69,999     성공
70,000         실패
70,001 ~       미처리
다시 처음부터 실행한다면 이미 저장된 69,999건은 어떻게 해야 할까요? 중복으로 생성돼도 되는지, 기존 데이터를 업데이트해야 하는지, 이전 작업을 모두 되돌려야 하는지 결정해야 합니다.
그래서 Load를 설계할 때는 다음과 같은 문제를 함께 생각하게 됩니다.
- 동일한 작업을 다시 실행해도 결과가 같은가
- 일부 데이터만 성공한 상태를 허용할 것인가
- 기존 데이터가 있다면 추가할 것인가, 수정할 것인가
- 서로 참조하는 데이터는 어떤 순서로 저장할 것인가
멱등성(Idempotency)이나 트랜잭션 같은 개념이 ETL에서도 자연스럽게 등장하는 이유입니다. Load는 마지막에 INSERT를 실행하는 단계라기보다, 실패와 재실행까지 고려해 데이터를 목적지에 정착시키는 단계라고 보는 편이 더 가깝습니다.
6. ETL은 실패와 재실행을 어떻게 다룰까
처음 ETL을 접하면 Extract, Transform, Load라는 세 단계 자체에 눈이 갑니다. 하지만 실제 운영에서는 실패한 데이터를 설명하고 다시 처리하는 일이 더 크게 느껴질 때가 있습니다.
예를 들어 어떤 데이터 하나가 실패했다고 가정해보겠습니다.
row 3812: organization not found
이때 다음 질문에 답할 수 있어야 합니다.
- 어떤 원본 데이터였는가?
- 어떤 변환 규칙이 적용되었는가?
- 어느 단계에서 실패했는가?
- 문제를 수정한 뒤 해당 데이터만 다시 처리할 수 있는가?
성공 여부만 기록하는 파이프라인으로는 이 질문에 답할 수 없습니다. 데이터 파이프라인을 운영하려면 왜 그런 결과가 나왔는지를 추적할 수 있어야 합니다. 그래서 ETL이 단순한 스크립트에서 하나의 시스템으로 커질수록 세 단계 외의 성질이 중요해집니다.
- 재현 가능성: 같은 입력과 같은 규칙으로 실행했을 때 같은 결과를 얻을 수 있어야 합니다.
- 재실행 가능성: 중간에 실패하더라도 체크포인트에서 이어 가거나 실패한 데이터만 다시 처리할 수 있어야 합니다. 전체 작업을 사람이 처음부터 다시 구성하지 않아도 되어야 합니다.
- 관찰 가능성: 어떤 데이터가 어느 단계에서 실패했는지 확인할 수 있어야 합니다.
- 추적 가능성: 결과 데이터가 어떤 원본과 어떤 변환 과정을 거쳤는지 따라갈 수 있어야 합니다.
7. ETL과 ELT는 무엇이 다른가
ETL을 찾아보다 보면 비슷하게 생긴 ELT(Extract, Load, Transform)라는 용어도 만나게 됩니다. ETL에서는 데이터를 목적지에 넣기 전에 먼저 가공합니다. ELT에서는 원본 데이터를 먼저 데이터 웨어하우스나 데이터 레이크 같은 대상 시스템에 적재하고, 그 안에서 필요할 때 변환합니다.
| 구분 | ETL | ELT |
|---|---|---|
| 순서 | Extract → Transform → Load | Extract → Load → Transform |
| 변환 위치 | 대상 시스템에 적재하기 전 | 대상 시스템에 적재한 뒤 |
| 대상에 적재되는 데이터 | 변환된 데이터 | 원본에 가까운 데이터 |
| 대표적인 활용 맥락 | 정해진 스키마와 규칙에 맞춰 데이터를 옮길 때 | 대규모 데이터를 먼저 수집하고 여러 용도로 활용할 때 |
클라우드 데이터 웨어하우스처럼 대상 시스템 자체의 저장 공간과 연산 능력이 충분해지면서 ELT도 널리 사용되고 있습니다. AWS와 IBM 모두 두 방식의 핵심적인 차이를 변환이 적재 전인지 후인지로 설명합니다.
ELT가 ETL을 대체하는 상위 방식인 것은 아닙니다. 분석을 위해 대규모 원본 데이터를 보존하고 여러 방식으로 다시 가공해야 한다면 ELT가 자연스러울 수 있습니다. 반대로 대상 시스템의 스키마와 도메인 규칙이 명확하고, 잘못된 데이터를 대상에 넣기 전에 걸러야 하는 데이터 마이그레이션에서는 ETL 방식이 더 자연스러울 수 있습니다.
결국 선택 기준은 데이터를 언제, 어디에서, 어떤 규칙으로 신뢰할 수 있는 상태로 만들 것인가에 있습니다.
8. 데이터 마이그레이션에서 다시 본 ETL
제가 ETL을 다시 공부하게 된 계기는 데이터 웨어하우스 구축이 아니었습니다. 그런데 고객사 데이터를 옮기던 그 작업에는 이미 ETL의 단계가 그대로 들어 있었습니다.
다만 사람이 엑셀에서 암묵적으로 하던 일을 시스템이 수행하게 되면서 각각의 단계가 눈에 보이기 시작했습니다. 어떤 컬럼이 무엇을 의미하는지 정의해야 했고, 어떤 변환이 허용되는지 규칙을 만들어야 했습니다. 오류가 발생했을 때 사용자가 원인을 이해하고 수정할 수 있어야 했고, 수정한 데이터를 다시 안전하게 처리할 수도 있어야 했습니다.
덕분에 ETL을 단순히 데이터 엔지니어링에서 사용하는 용어로만 보지 않게 되었습니다. 서로 다른 두 시스템 사이에 데이터가 이동한다면 그 사이에는 거의 항상 의미를 번역하는 과정이 존재합니다. ETL은 그 과정을 세 단계로 나눠 생각할 수 있게 해주는 오래되고 단순한 모델이고, 실제 시스템을 만들 때는 그 세 글자 사이에 검증, 실패, 재시도, 추적 같은 현실적인 문제들이 들어옵니다.
데이터를 옮긴다는 표현은 단순하지만, 서로 다른 시스템이 같은 데이터를 같은 의미로 이해하도록 만드는 일은 생각보다 많은 설계를 필요로 합니다.
References